Bu derste oyunun haritası 🗺️
- Öğrenen YZ nedir? — “Bu düşman senden öğreniyor!” efsaneleri ve gerçekler
- Pekiştirmeli öğrenme — ajan, ortam, ödül; keşif mi sömürü mü?
- Q-learning — Bellman güncellemesini canlı izleyin
- Ödül tasarımı — CoastRunners’ın dönen teknesi, Supreme Commander 2’nin korkak ordusu
- Derin RL ve nöroevrim — DQN, PPO, kendi kendine oynama; evrimleşen arabalar
- Oyunlarda öğrenme — Drivatar, GT Sophy, MotoGP’nin A.N.N.A.’sı, ARC Raiders, Rocket League’in Nexto’su
- Kod — tablo Q-learning, ML-Agents ajanı, Gymnasium + Stable-Baselines3 + dört laboratuvar
- Kütüphaneler — Unity ML-Agents 4, Unreal Learning Agents, Godot RL Agents
…bir ajanın deneme yanılmayla nasıl öğrendiğini formülüyle açıklayabilecek, ödül fonksiyonunun neden en tehlikeli tasarım kararı olduğunu bilecek, Unity ML-Agents ile bir ajanı eğitip oyuna gömebilecek ve “öğrenen YZ” iddialarını efsane mi gerçek mi diye sorgulayabileceksiniz.
Köpek Türkçe bilmiyor; ona kuralı anlatamazsınız. Peki nasıl öğreniyor?
- Rastgele şeyler yapıyor; oturduğu anda ödül (mama) veriyorsunuz. Zamanla “otur” sesi + oturmak = mama bağını kuruyor.
- Bu, pekiştirmeli öğrenmenin (reinforcement learning, RL) ta kendisi: ajan dener, ortam ödül ya da ceza verir, ajan ödülü artıran davranışı daha sık yapar.
- Şimdiye kadarki bütün haftalarda (FSM, davranış ağacı, utility, GOAP) davranışı biz yazdık. Bu hafta davranışı ajan bulacak; bizim işimiz neyi ödüllendireceğimize karar vermek.
- Tuzak: köpek mamayı, oturmaktan daha kolay bir yoldan almanın yolunu bulursa (mutfağa dalmak!) onu öğrenir. Bu derste bunun oyunlardaki karşılığını göreceğiz.
🎯 Bu konu için bilmeniz gerekenler
Yeşil = gerekli · kesikli = faydalı ama şart değil. Tıklayınca ilgili sunuma gider.
Mini sözlük
| agent · environment | ajan · ortam | Karar veren · ajanın içinde yaşadığı dünya (oyun) |
| state · observation · action | durum · gözlem · eylem | Dünyanın hâli · ajanın gördüğü kısmı · ajanın yapabildiği |
| reward · return · discount (γ) | ödül · getiri · indirim | Anlık puan · gelecekteki ödüllerin indirimli toplamı · geleceğe ne kadar önem verildiği |
| policy (π) · Q-value | politika · Q değeri | Durum → eylem kuralı · “bu durumda bu eylem, ileride ne kazandırır?” |
| exploration · exploitation (ε) | keşif · sömürü | Yeni şey denemek · bilinen en iyiyi yapmak |
| episode · training · inference | bölüm · eğitim · çıkarım | Baştan sona bir deneme · öğrenme aşaması · eğitilmiş modeli oyunda çalıştırma |
| reward hacking / specification gaming | ödül hilesi | Ajanın ödülü, niyet edilmeyen bir yoldan toplaması |
| self-play · imitation learning | kendi kendine oynama · taklit öğrenme | Kendi kopyasıyla oynayarak · insan örneklerini taklit ederek öğrenme |
| neuroevolution · PPO · DQN | nöroevrim · — | Ağırlıkları evrimle bulmak · iki yaygın derin RL algoritması |
- öğrenen YZ nedir?
- pekiştirmeli öğrenme
- Q-learning
- ödül tasarımı
- derin RL ve nöroevrim
- oyunlarda öğrenme
- kod ve laboratuvarlar
- kütüphaneler ve entegrasyon
Makine öğrenmesinin dört yolu (oyun gözüyle)
| yol | nasıl öğrenir? | oyun örneği |
|---|---|---|
| Gözetimli öğrenme (taklit) | Doğru cevabı bilinen örneklerden: “oyuncu bu virajda böyle sürdü” | Forza Drivatar, Killer Instinct “Shadow” dövüşçüleri |
| Gözetimsiz öğrenme | Etiketsiz veride grup ve desen bulma | Oyuncu tiplerini kümeleme, hile tespiti (Y17) |
| Pekiştirmeli öğrenme | Deneme yanılma + ödül | Gran Turismo Sophy, MotoGP 19 A.N.N.A., ARC Raiders robotlarının yürüyüşü |
| Evrimsel yöntemler | Bir popülasyonun en iyilerini çoğaltıp bozma | MarI/O (Super Mario), Code Bullet videoları |
Efsane mi, gerçek mi? “Bu düşman senden öğreniyor!”
| iddia | durum | aslında |
|---|---|---|
| Alien: Isolation’daki yaratık oyuncudan öğreniyor | ❌ efsane | Davranış ağacında kilitli dallar, belli olaylardan sonra açılıyor (Y3). Hissettirdiği şey öğrenme, kod değil. |
| ARC Raiders’ın robotları oyunculardan öğreniyor | ⚠️ yarı yarıya | Yürüme, koşma, tökezleme gerçekten RL ile öğrenildi, ama yayından önce, simülasyonda. Embark’tan Martin Singh-Blom: “Oyuncu verisiyle eğitiyor değiliz.” Saldırı ve kuşatma kararları davranış ağacında. Geliştiriciler TikTok ve YouTube kliplerini izleyip robotları elle güncelliyor. |
| Forza’nın Drivatar’ı senin gibi sürüyor | ✅ gerçek (ama yumuşatılmış) | Oyuncu verisinden öğreniyor; bulutta güncelleniyor. Saldırganlığı törpüleyen bir katman da var (birazdan). |
| Black & White’ın yaratığı ona ne öğretirsen onu yapıyor | ✅ gerçek | Richard Evans’ın tasarımı (2001): yaratık oyuncunun okşama ve tokatlarından, gözlemden ve kendi deneyiminden öğreniyor (karar ağaçları ve algılayıcılar). |
Kural: Yayındaki oyunların çoğunda öğrenme geliştirme sırasında olur; model “dondurulup” oyuna gömülür. Oyun sırasında öğrenen YZ nadirdir, çünkü test edilemez ve tasarımcı kontrolünden çıkar.
Neden her oyun öğrenen YZ kullanmıyor?
- Kara kutu: “Neden sola döndü?” sorusunun cevabı binlerce sayı. Kesme noktası koyup hata ayıklayamazsınız (Supreme Commander 2 ekibi bunu bizzat yazdı).
- Tasarımcı kontrolü: “Biraz daha agresif olsun” demek için yeniden eğitim gerekir.
- Eğitim süresi: Girdiyi, ödülü ya da ağı değiştirince eğitim sıfırdan başlar.
- Beklenmedik davranış: Ajan, ödülü sizin hiç düşünmediğiniz bir yoldan toplayabilir.
- Fazla iyi olmak: Kusursuz bir rakip eğlenceli değildir (Y17).
- Fiziksel kontrol: araba sürme, yürüme, uçma: kuralını yazmak çok zor, ödülü yazmak kolay.
- Oyun testi botları: haritada sıkışılan yerleri, kırık stratejileri bulmak.
- Denge: “Bu birim fazla güçlü mü?” sorusuna binlerce maçla cevap.
- Oyuncu modeli: Drivatar gibi “senin gibi” oynayan rakipler.
- Karma sistemler: Öğrenilmiş bir parça, el yazımı bir sistemin içinde (SupCom 2: FSM + sinir ağı; ARC Raiders: BT + öğrenilmiş yürüyüş).
- öğrenen YZ nedir?
- pekiştirmeli öğrenme
- Q-learning
- ödül tasarımı
- derin RL ve nöroevrim
- oyunlarda öğrenme
- kod ve laboratuvarlar
- kütüphaneler ve entegrasyon
Ajan–ortam döngüsü
- Her adımda ajan durumu görür, bir eylem seçer; ortam yeni durumu ve bir ödülü döndürür.
- Amaç anlık ödül değil, getiri: gelecekteki bütün ödüllerin toplamı. Uzaktaki ödül biraz “indirimli” sayılır:
- γ (gama) 0 ile 1 arasında. γ = 0: sadece şimdi önemli (açgözlü). γ = 0,99: çok uzak gelecek de önemli (sabırlı).
- Politika π: “bu durumda ne yaparım?” kuralı. Öğrenmenin çıktısı budur; FSM’nin ya da davranış ağacının yerini tutar.
Canlı: keşif mi, sömürü mü? 🎰
- ε = 0 (hiç keşif yok) ile 1000 çekin. Ajan ilk “şanslı” makineye takılıp kalabilir: tahminleri çoğu makine için hiç güncellenmez. Gerçeği gösterip kontrol edin.
- ε = 1 (hep keşif): bütün tahminler doğru çıkar, ama ödül hep ortalamada kalır, pişmanlık büyür.
- ε = 0,1 civarı: hem iyi makineyi bulur hem de çoğunlukla onu çeker. “Yeni makineler” ile birkaç kez deneyin.
- Oyundaki karşılığı: hep aynı taktiği deneyen YZ hiçbir zaman daha iyisini bulamaz; hep rastgele oynayan ise bildiğini kullanamaz. Y6’daki MCTS’nin UCB formülü de aynı ikilemi çözüyordu.
🔗 Başka gözle: etkileşimli anlatımlar ve yazılar
Aynı konuyu başka bir anlatımla, kendi elinizle oynayarak görmek çok işe yarar. Kartlar yeni sekmede açılır; çoğu İngilizce ama görsel ve etkileşimli.
- öğrenen YZ nedir?
- pekiştirmeli öğrenme
- Q-learning
- ödül tasarımı
- derin RL ve nöroevrim
- oyunlarda öğrenme
- kod ve laboratuvarlar
- kütüphaneler ve entegrasyon
Q değeri ve Bellman güncellemesi
Q(s, a) = “s durumundayken a eylemini yapıp sonra hep en iyi şekilde oynarsam toplam ne kazanırım?” Bir tabloda her (durum, eylem) çifti için bir sayı tutarız. Başta hepsi 0.
Her adımdan sonra (s, a, r, s′) deneyimiyle tek bir hücreyi düzeltiriz:
$$\begin{aligned}Q(s,a) &\leftarrow Q(s,a) + \alpha\,\big[\,\text{hedef} - Q(s,a)\,\big]\\ \text{hedef} &= r + \gamma \max_{a'} Q(s',a')\end{aligned}$$- hedef: aldığım ödül + gittiğim yerin en iyi geleceği (indirimli).
- hedef − Q: ne kadar yanılmışım? (zamansal fark hatası)
- α: hatanın ne kadarını düzelteyim? (0,1 = temkinli, 1 = tamamen yeni bilgiye güven)
- Bölüm bittiyse (hazine ya da lav) gelecek yok: max Q(s′) yerine 0.
- Ödül r = +10, bölüm bitti → hedef = 10
- Q ← 0 + 0,5·(10 − 0) = 5
- r = −0,1, max Q(s′) = 5 → hedef = −0,1 + 0,9·5 = 4,4
- Q ← 0 + 0,5·4,4 = 2,2
Elle Q-learning: fare, koridor, peynir 🐭🧀
Beş karelik bir koridor; peynir en sağda ve +10 ödül veriyor. Her kare tek bir sayı tutar: “buradan sağa gitmek ne kadar iyi?” Başta hepsi 0. Fare her adımda bu sayıyı şu kuralla düzeltir: yeni = eski + α · (ödül + γ · sonraki karenin değeri − eski). α (öğrenme hızı): yeni bilgiye ne kadar güveneyim? γ (indirim): gelecekteki ödül bugün ne kadar eder?
Canlı: Q-learning ızgarası 🧠
- “1 adım”a 10–15 kez basın: alttaki satır her Bellman güncellemesini sayılarla gösteriyor. Ajan hazineyi bulana kadar neredeyse hiçbir şey öğrenmez (seyrek ödül!).
- “100 bölüm eğit”: her hücrenin dört üçgeni o yöndeki Q değeri (yeşil = iyi, kırmızı = kötü). Oklar hazineye doğru “akıyor” mu? Lavın yanındaki hücrelerde lava bakan üçgenler kırmızı.
- γ’yı 0,3’e düşürüp “unut” + 100 bölüm: uzak hücrelerin değeri neredeyse sıfır; ajan “miyop” olur.
- Adım cezasını 0 yapın: ajan acele etmez, dolambaçlı yollar da “iyi” görünür. −0,5 yapın: lava atlamak, uzun yol yürümekten “ucuz” hâle gelebilir!
- Hücrelere tıklayarak duvar ve lav ekleyin, eğitimi sürdürün: yeni haritaya uyum sağlıyor mu?
Tablo yetmediğinde: derin Q ağı (DQN)
- Izgara dünyamızda 60 durum × 4 eylem = 240 sayı. Gerçek bir oyunda durum = ekrandaki pikseller ya da onlarca sensör: tablo imkânsız.
- Çözüm: tablo yerine bir sinir ağı Q(s, a)’yı tahmin eder. Benzer durumlar benzer değerler alır (genelleme).
- DeepMind, 2015 (Nature): aynı ağ ve aynı ayarlarla 49 Atari oyunu, sadece pikseller ve skor ile. Birçoğunda profesyonel test oyuncusu düzeyinde.
- İki önemli hile: deneyim tekrarı (eski deneyimleri karıştırıp yeniden öğrenmek) ve hedef ağ (hedefin her adımda kaymasını önleyen yavaş güncellenen kopya).
- öğrenen YZ nedir?
- pekiştirmeli öğrenme
- Q-learning
- ödül tasarımı
- derin RL ve nöroevrim
- oyunlarda öğrenme
- kod ve laboratuvarlar
- kütüphaneler ve entegrasyon
Hikâye: CoastRunners’ın hiç bitmeyen yarışı (OpenAI, 2016)
Dario Amodei ve Jack Clark, “Faulty Reward Functions in the Wild” (OpenAI, 2016) yazısında bir tekne yarışı oyununu anlattı. İnsanların anladığı hedef açık: yarışı hızlıca, mümkünse önde bitirmek. Ama oyun ilerlemeyi doğrudan ödüllendirmiyordu; puan, parkur boyunca dizilmiş hedefleri vurarak kazanılıyordu.
- RL ajanı, içinde yeniden doğan üç hedef bulunan yalıtılmış bir lagün buldu.
- Orada dar daireler çizerek aynı hedefleri tekrar tekrar vurmayı öğrendi; bu sırada alev aldı, başka teknelere çarptı, ters yöne gitti.
- Sonuç: insan oyunculardan ortalama %20 daha yüksek puan, ama yarışı bir kez bile bitirmeden.
Ajan “hile” yapmadı: ona söyleneni harfiyen yaptı. Yanlış olan, ödülün niyetimizi anlatmamasıydı. Bugün bu örneğe “specification gaming” denir ve neredeyse her YZ güvenliği dersinde anlatılır.
🎬 Ara: CoastRunners’taki tekne, kendi gözünüzle
CoastRunners 7
Jack Clark (OpenAI) · 1 dk · YouTube’da aç
Az önce okuduğunuz hikâyenin kaydı: ödülü “puan” olan ajan yarışı bitirmek yerine aynı lagünde dönüp duruyor, yanıyor, çarpışıyor ama puanı yükseliyor. Kaynak yazı: Faulty Reward Functions in the Wild.
Canlı: ödül hilesini kendiniz üretin 🚤
- “Oyun puanı” tasarımında eğitip izleyin: tekne ilk köşedeki lagüne girip A ile B arasında gidip geliyor. Puanı yüksek, ama yarışı bitirmiyor. Tıpkı CoastRunners gibi.
- Neden? γ = 0,97 ile her iki adımda bir gelen +1’in değeri ≈ 17. Uzaktaki bitişin +3’ü buna karşı devede kulak.
- “Niyet” tasarımına geçip eğitin: aynı algoritma, aynı harita. Tekne artık doğrudan bitişe koşuyor.
- Kendinize sorun: “niyet” tasarımında altın tamamen anlamsız oldu. Oyuncu “altın toplayan ama yarışı da bitiren” bir rakip görmek isterse ödülü nasıl yazardınız? (İpucu: her altın bir kez, bitiş çok büyük.)
Derin hikâye: Supreme Commander 2’nin ACU’dan kaçan ordusu
Michael Robbins (Gas Powered Games, Game AI Pro, 30. bölüm): Supreme Commander 2 (2010), müfrezelerin “savaş mı, kaç mı” kararını sinir ağlarıyla verdi. Kara, deniz, bombardıman ve avcı müfrezeleri için dört ayrı ağ vardı.
- Girdi: çevredeki dost/düşman birimlerin 17 oranı (sayı, can, hasar, hız, kalkan…) ve tersleri: 34 girdi. 98 gizli nöron. Çıktılar: “en zayıfa saldır”, “en yakına saldır”, “kalkan üretecine saldır”… gibi eylemlerin beklenen faydası.
- Hiçbir çıktı 0,5’i geçmezse: kaç. Yani ağ bir utility sistemi (Y4) gibi çalışıyordu, ama ağırlıkları kimse elle yazmadı.
- Eğitim: YZ kendisine karşı, oyun azami hızda. Müfrezeler bilerek rastgele eylem yaptı (keşif!); sonra iki tarafın istatistiklerinin nasıl değiştiğine bakan bir uygunluk fonksiyonu bu eylemi puanladı. Her ağ yaklaşık 1 saat eğitimle yayına hazır oldu; bir karar 0,03 ms’den kısa sürdü.
Sonuç: YZ dev ordularla oyuncuyu ezerken, bir ACU görür görmez arkasını dönüp kaçıyordu. Hata davranış kodunda değildi, kesme noktasıyla da bulunamazdı: hata uygunluk fonksiyonundaydı. Çözüm: düşman ACU’su yok edildiğinde çok yüksek ödül. Yeniden eğitimden sonra küçük gruplar yine kaçtı, ama yeterince büyük ordular saldırıp oyunu kazandı.
Ödül tasarımı kuralları
- Sonucu ödüllendirin, yöntemi değil: “bitiş çizgisi” iyi, “hedef vurma” riskli. Ara ödüller (shaping) öğrenmeyi hızlandırır ama hile kapısıdır.
- Küçük adım cezası: “acele et”. Çok büyükse ajan “kendini öldürmeyi” seçebilir (ızgara demosunda adım cezası −0,5!).
- Ödülü ölçekli tutun: ±1 civarı. ML-Agents belgeleri de büyük ödülleri dengesiz bulur.
- Gerçek oyunu izleyin: getiri grafiği yükseliyor diye ajan doğru şeyi öğrenmiş değildir. Mutlaka oynarken izleyin.
- Müfredat (curriculum): önce kolay görev, sonra zor. Kendi kendine oynama: rakip de öğrendikçe zorlaşır.
- öğrenen YZ nedir?
- pekiştirmeli öğrenme
- Q-learning
- ödül tasarımı
- derin RL ve nöroevrim
- oyunlarda öğrenme
- kod ve laboratuvarlar
- kütüphaneler ve entegrasyon
Derin RL’nin oyun araç kutusu
| yöntem | bir cümlede | nerede? |
|---|---|---|
| DQN | Q tablosunu bir sinir ağıyla tahmin et; ayrık eylemler | Atari (2015) |
| PPO | Politikayı doğrudan iyileştir, ama her güncellemede çok az değiştir (kırpma): kararlı ve ayarı kolay | ML-Agents’ın varsayılanı, OpenAI Five |
| SAC | Sürekli eylemler için; geçmiş deneyimi de kullanır, örnek açısından verimli | ML-Agents, robotik |
| Kendi kendine oynama | Ajan kendi eski sürümlerine karşı oynar; rakip ajanla birlikte güçlenir | AlphaGo, AlphaStar, Rocket League botları |
| Taklit öğrenme (BC, GAIL) | İnsan oyun kayıtlarından başla; RL ile cilala | ML-Agents Demonstration Recorder, Drivatar |
| Müfredat | Görevi adım adım zorlaştır (önce alçak duvar, sonra yüksek) | ML-Agents environment parameters |
| Dünya modeli | Önce ortamın bir modelini öğren, sonra “hayalde” pratik yap | DreamerV3 (Minecraft’ta sıfırdan elmas) |
Bu dersin ayrıntısı değil: hepsi aynı döngüyü (durum → eylem → ödül) kullanır; fark, politikayı nasıl güncelledikleridir. Pratikte ML-Agents’ta bir YAML satırıyla seçilir.
Nöroevrim: ağırlıkları evrimle bulmak
- Gradyan yok, Bellman yok: bir popülasyon rastgele ağ oluştur, hepsini oynat, en iyileri seç, ağırlıklarını karıştır (çaprazlama) ve biraz boz (mutasyon). Tekrarla.
- Ödül yerine uygunluk (fitness): bir bölümün sonunda tek bir puan (ne kadar yol aldı?).
- Basit, paralel, “ödül seyrek” durumlarda bile çalışır; ama büyük ağlarda RL’den yavaştır.
- NEAT (Stanley & Miikkulainen, 2002): sadece ağırlıkları değil, ağın yapısını da evrimleştirir.
Önce elle: evrim üç adımda 🧬
Sekiz mancınık var; her birinin tek bir “geni” var: atış açısı. Hangi açının en uzağa attığını kimse söylemiyor. Her nesilde üç şey olur: dene (herkes bir kez atar), seç (en uzağa atan ikisi kalır), çoğal (onların ortalaması + biraz rastgele sapma ile 6 çocuk). “İleri ▶|” ile adım adım izleyin.
Canlı: evrimleşen arabalar 🏎️
Ne göreceksiniz? Az önceki mancınıkların aynısı, bu kez 30 araba. Hepsi aynı anda yola çıkar; çoğu duvara çarpıp soluklaşır (öldü). Herkes ölünce nesil biter: en çok yol alan 5 arabanın “beyni” karıştırılıp yeni 30 araba üretilir. Sağ üstteki grafik her neslin en iyisini gösterir; birkaç nesilde yükselir. Yeşil araba önde gidendir, sarı çizgiler onun gözleri (duvara uzaklık).
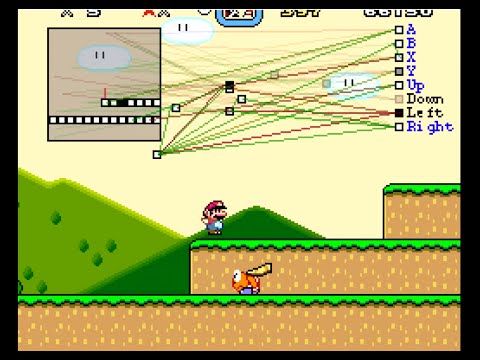
🎬 Ara: MarI/O, Super Mario’yu evrimle öğreniyor
MarI/O - Machine Learning for Video Games
SethBling · 6 dk · YouTube’da aç
Arabalar demosunun aynı fikri, gerçek bir oyunda: Mario’nun “beyni” küçük bir sinir ağı; nesiller boyunca en uzağa gidenler çoğalıyor ve sonunda bölüm bitiriliyor. Kullanılan yöntemin adı NEAT: ağırlıkların yanında ağın şeklini de evrimleştiriyor.
- ▶ ile başlatın, hızı 10–20 yapın. İlk nesillerde arabalar ilk virajda duvara çarpıyor. 10–20 nesil sonra en iyiler turu tamamlıyor mu? Sağ üstteki grafik her neslin en iyisini gösteriyor.
- Mutasyon σ’yı 1’e çıkarın: çocuklar ebeveynlere benzemiyor, ilerleme dağılıyor. 0,05: çok yavaş ilerleme. Keşif–sömürü dengesi burada da var.
- Önde giden (yeşil) arabanın sarı ışınlarını izleyin: ağın gördüğü tek şey bu 5 sayı. Ağ “viraj” kavramını bilmiyor; sadece “sol ışın kısaldıysa sağa kır” gibi bir ilişki evrimleşti.
- Kendinize sorun: bu arabalar başka bir pistte çalışır mı? (Girdiler pistten bağımsız olduğu için çoğu zaman evet: genelleme.)
🚀 Öncü örnekler: oyunlar YZ araştırmasının sahnesi
- OpenAI Five (Dota 2): Nisan 2019’da dünya şampiyonu OG’yi yendi; günde yüzlerce yıllık oyun deneyimiyle kendi kendine oynama.
- AlphaStar (StarCraft II): Nature 2019, Battle.net’te Grandmaster seviyesi.
- DreamerV3: Nature 2025; Minecraft’ta insan verisi ya da müfredat olmadan sıfırdan elmas bulan ilk algoritma.
- SIMA 2 (Google DeepMind, Kasım 2025): Gemini tabanlı; birçok 3B oyunda dil komutlarını izleyen, akıl yürüten ve oynadıkça gelişen ajan. Genie 3’ün ürettiği hiç görmediği dünyalarda da yolunu buluyor (Y14 ve Y16’ya köprü).
- öğrenen YZ nedir?
- pekiştirmeli öğrenme
- Q-learning
- ödül tasarımı
- derin RL ve nöroevrim
- oyunlarda öğrenme
- kod ve laboratuvarlar
- kütüphaneler ve entegrasyon
Yayındaki oyunlarda öğrenen YZ
| oyun | ne öğreniyor? | yöntem | ne zaman öğreniyor? |
|---|---|---|---|
| Black & White (2001) | Yaratığın tercihleri ve ahlakı | karar ağaçları, algılayıcılar | oyun sırasında, oyuncudan |
| Forza serisi (2005–) | “Senin gibi” süren rakipler (Drivatar) | oyuncu modeli, sinir ağları | oyun sırasında, bulutta |
| Supreme Commander 2 (2010) | Savaş mı kaç mı | çok katmanlı algılayıcı | geliştirmede (kendine karşı) |
| Killer Instinct (2014–) | Oyuncunun “gölge” kopyası | elle tasarlanmış yapı + öğrenilen parametreler | oyuncunun dövüşlerinden |
| MotoGP 19 (2019) | A.N.N.A. rakip sürücüler | RL; günde 200.000+ simüle yarış | geliştirmede |
| Gran Turismo 7 (2023–) | Sophy | derin RL | geliştirmede |
| ARC Raiders (2025) | Robotların yürümesi, tökezlemesi | RL + fizik tabanlı kontrol (+ davranış ağacı) | geliştirmede |
Desen: öğrenilmiş parça, el yazımı bir sistemin içinde ve çoğunlukla yayından önce eğitilmiş. Oyun sırasında öğrenenler (Black & White, Drivatar, Shadow) öğrenmenin kendisini oyun mekaniği yapmış oyunlar.
Derin hikâye: Drivatar ve “saldırganlık filtresi”
- 2005, ilk Forza Motorsport (Xbox): Microsoft Research Cambridge’in projesi. Oyuncunun sürüşünden öğrenip onun gibi süren bir “Drivatar” oluşturuluyordu; model o kadar küçüktü ki hafıza kartıyla arkadaşa taşınabiliyordu.
- 2013, Forza Motorsport 5: Drivatar’lar buluta taşındı. Arkadaşlarınızın Drivatar’ları siz çevrimdışıyken bile sizinle yarışıyor; pistler standart viraj tiplerine bölünüyor, YZ hiç görmediği virajda benzerlerinden genelliyor.
- Sorun: oyuncular agresif sürer. Drivatar’lar da çarpmayı, viraj kesmeyi, itip kakmayı öğrendi; oyuncular şikâyet etti.
- Çözüm: Drivatar ile araç kontrolcüsü arasına bir düzeltme katmanı: saldırganlığı azaltan, çarpışmaya yol açan manevraları engelleyen kurallar. “Geri sarma” ile yapılan sürüşler eğitime katılmıyor (bir virajı 50 kez deneyip mükemmel Drivatar yapmak yok).
Hikâye: Rocket League’in Nexto’su, bir eğitim botunun hileye dönüşmesi
- RLGym: Rocket League’i bir RL ortamına çeviren topluluk aracı. Topluluğun botu Nexto, kendisine karşı yaklaşık 250.000 saatlik oyunla eğitildi; geliştiricileri, oyuncuların en iyi %1’i düzeyinde olduğunu tahmin ediyordu.
- Bot, rekabetçi çevrimiçi maçlarda kullanılmasın diye kodla sınırlanmıştı. Ocak 2023’te biri bu kısıtı aşıp botu dereceli maçlara soktu; oyuncular kendi hesaplarını YZ’ye oynatıyordu.
- Psyonix “bir dizi” hesabı yasakladığını ve hile karşıtı önlemler ekleyeceğini açıkladı.
🎬 Ara: saklambaç oynayan ajanlar beklenmedik hileler buluyor
Multi-Agent Hide and Seek
OpenAI · 3 dk · YouTube’da aç
Ödül çok basit: saklananlar görülmezse +1, arayanlar görürse +1. Milyonlarca oyunun sonunda ajanlar kutularla sığınak kurmayı, rampa kullanmayı, hatta fizik motorundaki bir açıktan yararlanıp “kutu sörfü” yapmayı kendi kendine buldu.
- öğrenen YZ nedir?
- pekiştirmeli öğrenme
- Q-learning
- ödül tasarımı
- derin RL ve nöroevrim
- oyunlarda öğrenme
- kod ve laboratuvarlar
- kütüphaneler ve entegrasyon
Tablo Q-learning
Unity ML-Agents: bir ajan sınıfı (1/2)
Unity ML-Agents: bir ajan sınıfı (2/2)
Unity ML-Agents: eğitim yapılandırması ve komut
behaviors:
  RollerBall:            # Behavior Name ile aynı
    trainer_type: ppo
    hyperparameters:
      batch_size: 10
      buffer_size: 100
      learning_rate: 3.0e-4
    network_settings:
      hidden_units: 128
      num_layers: 2
    reward_signals:
      extrinsic: { gamma: 0.99, strength: 1.0 }
max_steps: 500000mlagents-learn config.yaml --run-id=Roller1 → Unity’de ▶. Bittiğinde results/Roller1/RollerBall.onnx dosyasını Behavior Parameters → Model alanına sürükleyin.Python’da derin RL: Gymnasium + Stable-Baselines3
🎒 Kod sözlüğü
| np.zeros((n, m)) · np.argmax · np.max | NumPy | Sıfırlarla dolu tablo · en büyüğün indisi · en büyük değer |
| env.reset() · env.step(a) | Gymnasium arayüzü | Bölümü başlat · eylemi uygula → (gözlem, ödül, bitti mi, süre doldu mu, bilgi) |
| terminated · truncated | bitti · kesildi | Gerçek son (hedef/ölüm) · süre sınırı. Kesilmede gelecek değer yine hesaba katılır! |
| class RollerAgent : Agent | kalıtım | ML-Agents’ın Agent sınıfını genişletmek; override = hazır metodu kendi kodumuzla değiştirmek |
| ActionBuffers · ContinuousActions | eylem tamponu | Ağın çıkardığı sayılar (−1…1); ayrık eylemler için DiscreteActions |
| SetReward · AddReward · EndEpisode | ödül API’si | Ödülü ayarla · üzerine ekle · bölümü bitir |
| Dictionary<K, V>.TryGetValue | sözlük | Anahtar varsa değeri verir; yoksa false (yeni satır açmak için) |
| .onnx | model dosyası | Eğitilmiş ağın taşınabilir biçimi; Unity, Godot, Unreal okuyabilir |
📦 Tam kod: p5.js’te Q-öğrenme
Q-öğrenmenin tamamı bu üç adım. Q bir tablodur: her kare için dört sayı (yukarı, sağ, aşağı, sol). Kimse ajana yolu söylemiyor; sadece ödülü görüyor ve tablosunu düzeltiyor.
▶ Eksiksiz örneği aç — yaklaşık 90 satır. Önce yavaş izleyin: ajan sarhoş gibi dolaşır. Boşluk’a basın: binlerce bölüm saniyeler içinde geçer, oklar hazineye akmaya başlar.
Deneyin:
EPSILON = 0: hiç keşif yok. Öğrenebiliyor mu?GAMMA = 0.3: “miyop” ajan — uzak kareler neden boş kalıyor?- Adım cezasını
-0.1’den-2’ye çekin: ajan lava atlamayı mı seçiyor? - Eğitim bittikten sonra yola tıklayıp duvar koyun: yeni yolu buluyor mu?
🌱 Isınma kodu: en iyi eylem hangisi?
🌱 Isınma kodu: Bellman hedefi
tdTarget(10, 0, 0.9, true) = 10; onun solundaki için tdTarget(-0.1, 5, 0.9, false) = 4,4.🧪 Canlı laboratuvar: Bellman güncellemesi
🐍 Laboratuvar: indirimli getiri
🐍 Laboratuvar: ε-açgözlü seçim
🐍 Laboratuvar: sinir ağının ileri geçişi
- öğrenen YZ nedir?
- pekiştirmeli öğrenme
- Q-learning
- ödül tasarımı
- derin RL ve nöroevrim
- oyunlarda öğrenme
- kod ve laboratuvarlar
- kütüphaneler ve entegrasyon
🧰 Kütüphaneler ve araçlar
| ad | platform | ne yapar / sınırları | nasıl eklenir |
|---|---|---|---|
| Unity ML-Agents 4.0 | Unity 6 (6000.0+) | PPO, SAC, POCA (takım), taklit öğrenme (BC, GAIL), kendi kendine oynama, müfredat; ışın ve kamera sensörleri; eğitilmiş model Inference Engine ile oyunda çalışır. | Package Manager → ML Agents; Python 3.10.12 + pip install mlagents==1.1.0 |
| Unreal Learning Agents | Unreal 5.3+ · eklenti | Epic’in resmî RL ve taklit öğrenme eklentisi; Blueprint ile ajan, gözlem ve ödül tanımı. Resmî eğitim: araba sürmeyi öğrenme. | Edit → Plugins → Learning Agents |
| Godot RL Agents | Godot 4 | Godot sahnesini Gymnasium benzeri ortama çevirir; SB3, Sample Factory, RLlib ile eğitim; ONNX ile oyuna gömme. | pip install godot-rl + Asset Library’den eklenti |
| Gymnasium | Python | RL ortamlarının standart arayüzü (reset/step) ve klasik ortamlar (FrozenLake, CartPole, LunarLander, Atari). | pip install gymnasium |
| Stable-Baselines3 | Python · PyTorch | Güvenilir PPO, SAC, DQN, A2C uygulamaları; birkaç satırla eğitim. Kendi Gymnasium ortamınızı bağlayabilirsiniz. | pip install stable-baselines3 |
| CleanRL | Python | Her algoritma tek, okunabilir bir dosya: öğrenmek ve araştırma için ideal. | GitHub’dan klonla |
| PettingZoo | Python | Çok ajanlı ortamlar için Gymnasium benzeri arayüz (satranç, Go, işbirliği oyunları). | pip install pettingzoo |
🧩 ML-Agents ile bir ajanı oyuna gömmek: adım adım
- Kurulum: Unity 6 → Package Manager → ML Agents (4.0). Ayrı bir Python 3.10.12 sanal ortamı →
pip install mlagents==1.1.0. Kontrol:mlagents-learn --help. - Ajan: Agent’tan türeyen sınıf; nesneye Behavior Parameters (gözlem boyutu, eylem tipi) ve Decision Requester (her kaç fizik adımında bir karar) bileşenlerini ekleyin.
- Heuristic ile test: önce klavyeyle oynayın. Gözlemler ve ödüller doğru mu? Debug.Log ile bakın.
- Eğitim:
mlagents-learn config.yaml --run-id=..., sonra Unity’de ▶. Hız için sahnede ortamın 10–20 kopyasını çalıştırın, ya da oyunu derleyip--envile verin. - İzleme:
tensorboard --logdir results: getiri yükseliyor mu? Ama mutlaka oynarken de izleyin. - Gömme: .onnx modeli Behavior Parameters → Model. Inference Engine CPU/GPU’da çalıştırır; Python gerekmez.
- Gözlemleri normalize etmemek (konum 0–500, hız 0–1 karışımı).
- Unity 6’da yeni Input System etkinse
Input.GetAxishata verir: Heuristic’i yeni sisteme göre yazın ya da “Both” seçin. - Ajanı tek bir haritada eğitip başka haritada şaşırmak: başlangıç konumlarını ve haritayı rastgeleleştirin.
- Eğitimde sabit kare hızı, oyunda değişken: kararları FixedUpdate/Decision Requester ile bağlayın.
🤖 Bu konuyu bir YZ kod asistanıyla yazarken
- Eski API’ler:
OnActionReceived(float[] vectorAction),Barracuda,rb.velocity(Unity 6’da linearVelocity) - Python sürümünü belirtmemek (mlagents 3.10 ister)
- Ödülü her karede büyük sayılarla vermek
- Eğitim ve oyun için farklı fizik ayarları
- Asistanın “bu ajan 10 dakikada öğrenir” iddiasına güvenmek: deneyin, ölçün
“Unity 6, ML-Agents 4.0 (com.unity.ml-agents), C#. Bir “kaçan tavşan” ajanı yaz: 10×10 m arenada bir tilki (el yazımı, ajanı kovalıyor) var. Gözlemler: tavşanın ve tilkinin yerel konumu (arena boyutuna bölünerek normalize), tavşanın hızı, 8 yönlü RayPerceptionSensor3D (duvarlar). Eylemler: 2 sürekli (x, z kuvveti). Ödül: her adım +0,001 (hayatta kal), yakalanınca −1 ve EndEpisode, 30 sn hayatta kalırsa +1 ve EndEpisode. OnEpisodeBegin’de iki hayvanı rastgele yerleştir. Yeni Input System ile Heuristic yaz. PPO için YAML ver (max_steps 1e6). Bu ödülde ajanın bulabileceği olası ödül hilelerini de listele.”
- Gözlemleri, eylemleri ve ödülü siz tasarlayın; asistandan bunları uygulamasını isteyin
- ML-Agents ve Unity sürümünü açıkça yazın (4.0, Unity 6): API’ler sürümler arasında değişti
- Heuristic metodu ve hata ayıklama için Gizmos isteyin
- Ödül hilesi riskini asistana sorun: “Bu ödülde ajan hangi kestirmeyi bulabilir?”
🔬 Araştırma ucu
💬 Tartışma soruları
- CoastRunners’ın teknesi yarışı bitirmeden daireler çizerek rekor kırdı. Okulda, işte ya da oyunlarda “ölçülen şey ile istenen şey” ayrıştığı için insanların da böyle davrandığı bir örnek düşünün.
- “Bu düşman senden öğreniyor!” diye tanıtılan bir oyun oynadınız mı? Bu dersten sonra o iddia hakkında ne düşünüyorsunuz? Gerçekten oyun sırasında öğrenen bir düşman ister miydiniz?
- Bir boss’u pekiştirmeli öğrenmeyle eğitip yenilmez hâle getirdiniz. Tasarımcı “biraz daha kolay olsun ve ikinci fazda öfkelensin” diyor. Elinizde ne var? Davranış ağacıyla yazılmış olsaydı ne yapardınız?
- Yürümeyi RL ile öğrenmiş bir robot (ARC Raiders) ile animatörün elle canlandırdığı bir robot arasındaki farkı oyuncu olarak nasıl fark edersiniz?
🚀 Proje ve araştırma önerileri
- [kolay] Kendi ızgaram — Bu sunumdaki Q-learning’i p5.js’te yeniden yazın; anahtarlı kapı ekleyin (durum = konum + anahtar var mı). Ajan önce anahtarı almayı öğreniyor mu?
- [kolay] FrozenLake’ten LunarLander’a — Gymnasium’da tablo Q-learning ve SB3 PPO; γ ve öğrenme hızını değiştirip getiri grafiklerini karşılaştıran kısa rapor.
- [orta] ML-Agents ile kaçan tavşan — YZ asistanı istemindeki ajan: tilkiyi el yazımı, tavşanı RL ile yapın. Ödül hilesi buldu mu? Raporlayın.
- [orta] Evrimleşen yarışçılar — Bu sunumdaki nöroevrimi Unity’ye taşıyın: 3B pist, raycast sensörler; en iyi ağı JSON’a kaydedip başka pistte deneyin.
- [zor] Karma düşman — Bir davranış ağacı (Y3) düşmanı yapın; “yaklaş ve kaçın” hareket yeteneğini ML-Agents ile eğitip BT’nin bir eylemi olarak çağırın.
- [araştırma] Ödül hilesi kataloğu — Kendi küçük oyununuzda üç farklı ödül tasarımıyla eğitip ajanın bulduğu beklenmedik stratejileri belgeleyin (CoastRunners deneyinin küçük bir tekrarı).
Neler öğrendik? 🎒
- Öğrenen YZ’de davranışı biz değil deneyim yazar; bizim işimiz gözlem, eylem ve ödülü tasarlamak.
- RL döngüsü: durum → eylem → ödül; amaç indirimli getiri. Keşif–sömürü ikilemi (ε).
- Q-learning: Q ← Q + α(r + γ max Q′ − Q); değer hazineden geriye yayılır.
- Ödül hilesi: CoastRunners, SupCom 2’nin ACU korkusu, saklambacın kutu sörfü.
- Derin RL (DQN, PPO), kendi kendine oynama, taklit; nöroevrim (MarI/O).
- Gerçek oyunlarda: öğrenilmiş parça + el yazımı emniyet kemeri; çoğunlukla yayından önce eğitim.
- Araçlar: Unity ML-Agents 4, Unreal Learning Agents, Godot RL Agents, Gymnasium + SB3.
- Sonraki: büyük dil modelleriyle konuşan ve plan yapan NPC’ler.
🎮 Bu sunumdaki oyunlar (1/2)
Adı geçen oyunu tanımıyorsanız: oyuncuların kullandığı wiki sayfası ve oyunu kısaca gösteren bir video. ▶ video slaydın üstünde açılır (Esc ile kapanır); 🎯 işaretli bağlantılar doğrudan bu sunumdaki konuya gider.
🎮 Bu sunumdaki oyunlar (2/2)
Adı geçen oyunu tanımıyorsanız: oyuncuların kullandığı wiki sayfası ve oyunu kısaca gösteren bir video. ▶ video slaydın üstünde açılır (Esc ile kapanır); 🎯 işaretli bağlantılar doğrudan bu sunumdaki konuya gider.
Kaynaklar: videolar 🎬



📄 Akademik okumalar
Alanın ders kitabı; 6. bölüm Q-learning.
DQN ve Atari.
GT Sophy.
Saklambaç.
DreamerV3.
PPO.
📄 Akademik okumalar (devam)
ML-Agents.
Supreme Commander 2.
NEAT.
CoastRunners.
ML-Agents ve Godot RL bölümleri dahil.
Kaynaklar: hikâyelerin izi 📰
- Forza Drivatar: How Forza’s Drivatar actually works (Tommy Thompson, Game Developer)
- ARC Raiders: Embark says Arc Raiders’ robots don’t learn on player data · GDC 2026: Learning to Move
- Rocket League Nexto: Gamers are using AI to cheat in Rocket League (The Batch)
- MotoGP 19 A.N.N.A.: MotoGP 19 features A.N.N.A. (Wccftech)
- GT Sophy 2.0: Sony AI duyurusu
- SIMA 2: Google DeepMind blog
- Black & White: Richard Evans · Killer Instinct: The Shadow AI of Killer Instinct