ÖYG213 · YAPAY ZEKA DESTEKLİ YAZILIM GELİŞTİRME
Büyük Dil Modelleri
1. Bölüm — LLM nedir, nereden geldi, metni nasıl görür?
- Tanım
- Tarihçe
- Token
Anadolu Üniversitesi · Bilişim Teknolojileri MYO · Ekim 2026 · Yön tuşlarıyla ilerleyin, T tema, + / − yazı boyutu, Esc genel görünüm
 Güvenç Usanmaz · github.com/gusanmaz
Bu ünitenin haritası
Sıra önemli: her bölüm bir öncekinin kavramlarını kullanır. Token bilinmeden bağlam penceresi, bağlam penceresi bilinmeden halüsinasyon anlaşılmaz.
Bugün bir yapay zekâya kaç soru sordunuz?
ISINMA · LOGOYU TANI
Bu logo neyin logosu?

OpenAI
2015'te San Francisco'da kurulan şirket. Ürünü ChatGPT de aynı simgeyi kullanır; modellerinin adı GPT'dir.
ISINMA · LOGOYU TANI
Peki bu?

Claude
Claude hem uygulamanın hem modelin adıdır. Üreten şirket:  Anthropic (2021'de kuruldu; kendi logosu farklıdır).
ISINMA · LOGOYU TANI
Bu?

Gemini
Gemini hem uygulamanın hem modelin adıdır. Üreten şirket:  Google. Transformer'ı da Google icat etmişti.
ISINMA · LOGOYU TANI
Bu?

DeepSeek
Şirketin de modelin de adı DeepSeek. 2023'te Çin'in Hangzhou kentinde kuruldu. Ocak 2025'te çıkardığı R1 modeli, ucuzluğu ve gücüyle sektörü şaşırttı.
ISINMA · LOGOYU TANI
Bu?

Meta
Facebook, Instagram ve WhatsApp'ın sahibi olan şirket. Peki modelinin adı ne?
ISINMA · LOGOYU TANI
Meta'nın modeli: Llama

LLaMA = Large Language Model Meta AI
- Şubat 2023'ten beri indirilebilir (açık ağırlıklı)
- Ayrı bir resmî logosu yok; Meta logosuyla anılır
- Lama, açık model dünyasının gayriresmî maskotu oldu: Ollama, llama.cpp, LlamaIndex…
ISINMA · LOGOYU TANI
Zorlaşıyor…

Mistral
şirket ve model · Paris

Grok
ürün · şirketi xAI

Qwen
model · şirketi Alibaba

Kimi
model · şirketi Moonshot AI
ISINMA · LOGOYU TANI
Şirketin logosu ile ürünün logosu ayrıdır
| Şirket | Ürün / model | ||
|---|---|---|---|
| Anthropic | | Claude |
| | Gemini | |
 | xAI | | Grok |
 | Alibaba | | Qwen |
 | Moonshot AI | | Kimi |
Karıştırmak kolay: bir haberde “Anthropic” geçer, uygulamada “Claude” yazar. Anthropic şirketin, Claude ise o şirketin ürününün adıdır.
ISINMA · LOGOYU TANI
BU KİM?Logoların arkasındaki insanlar
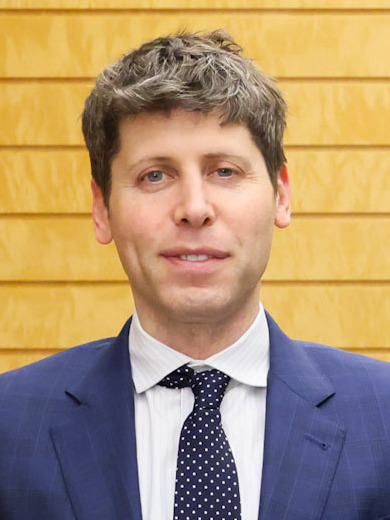
Sam AltmanOpenAI'ın yöneticisi
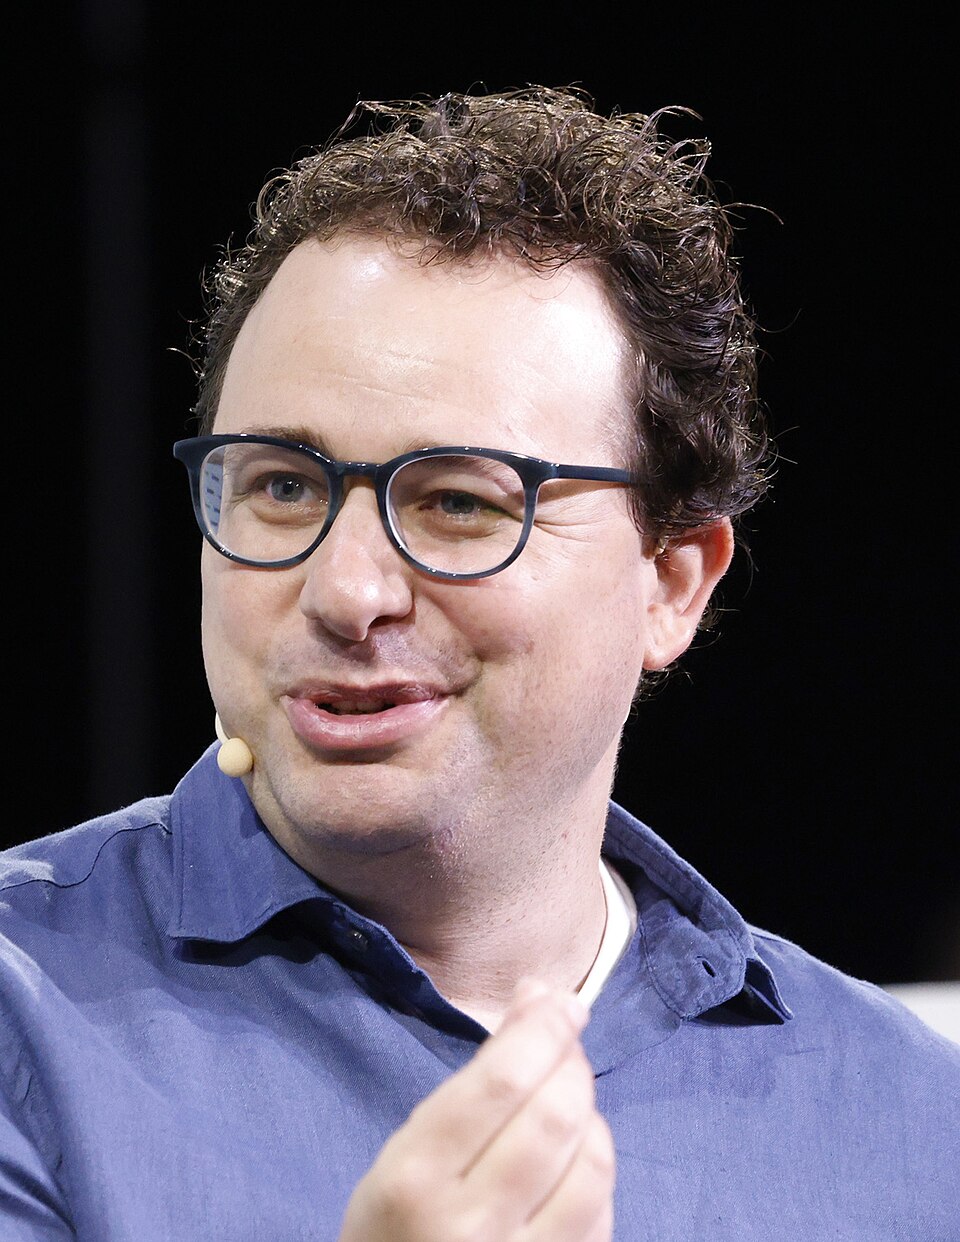
Dario AmodeiAnthropic'in kurucu ortağı ve yöneticisi
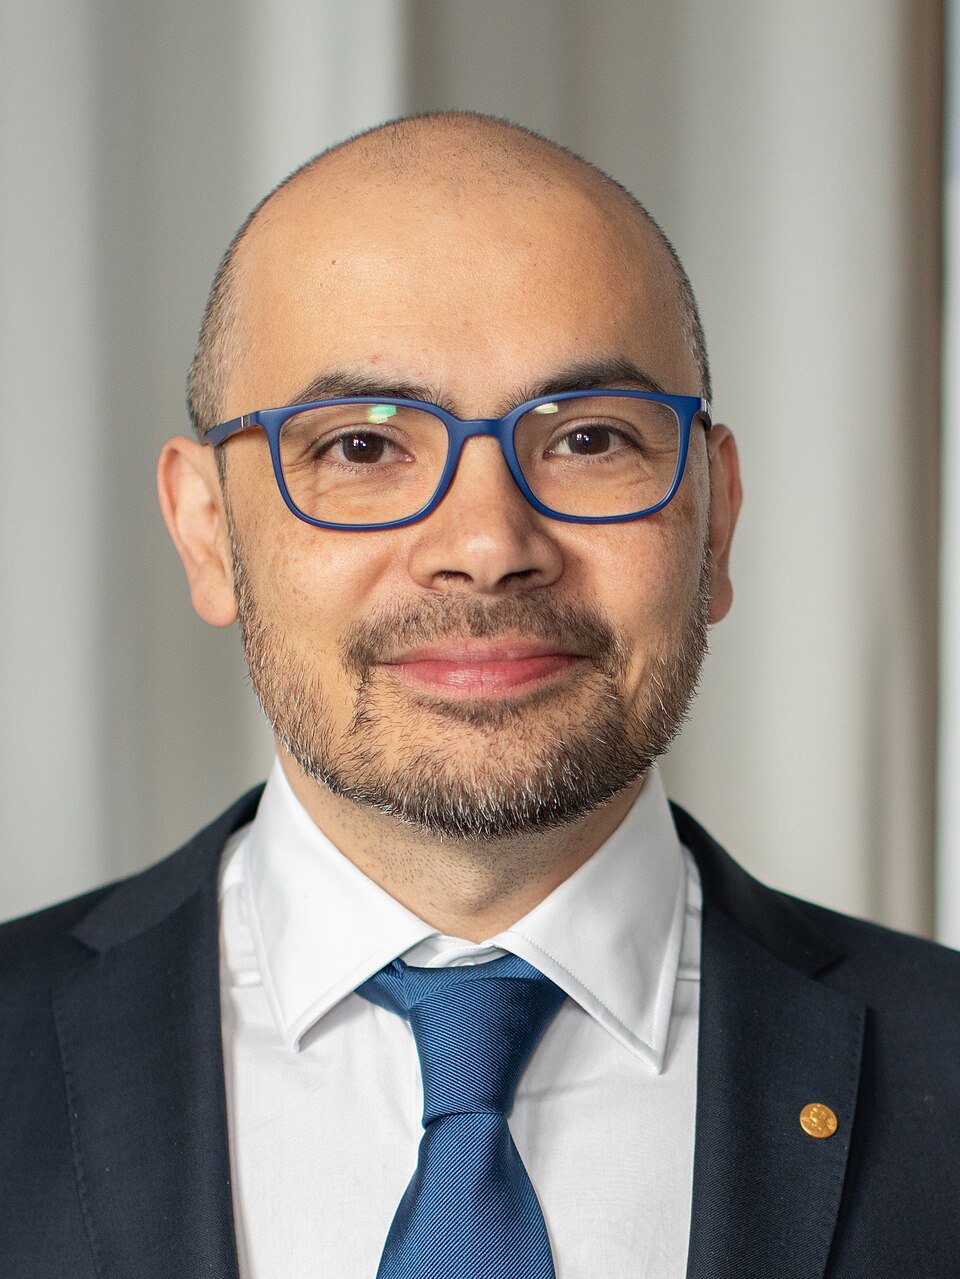
Demis HassabisGoogle DeepMind'ın yöneticisi; 2024 Nobel Kimya Ödülü
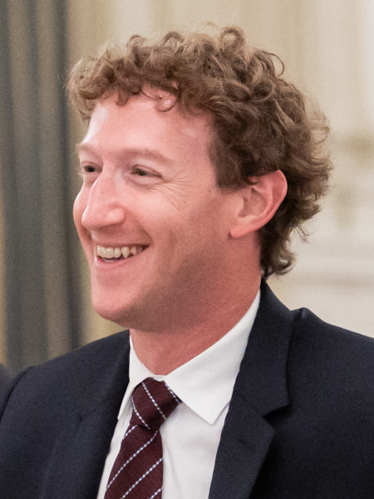
Mark ZuckerbergMeta'nın kurucusu ve yöneticisi
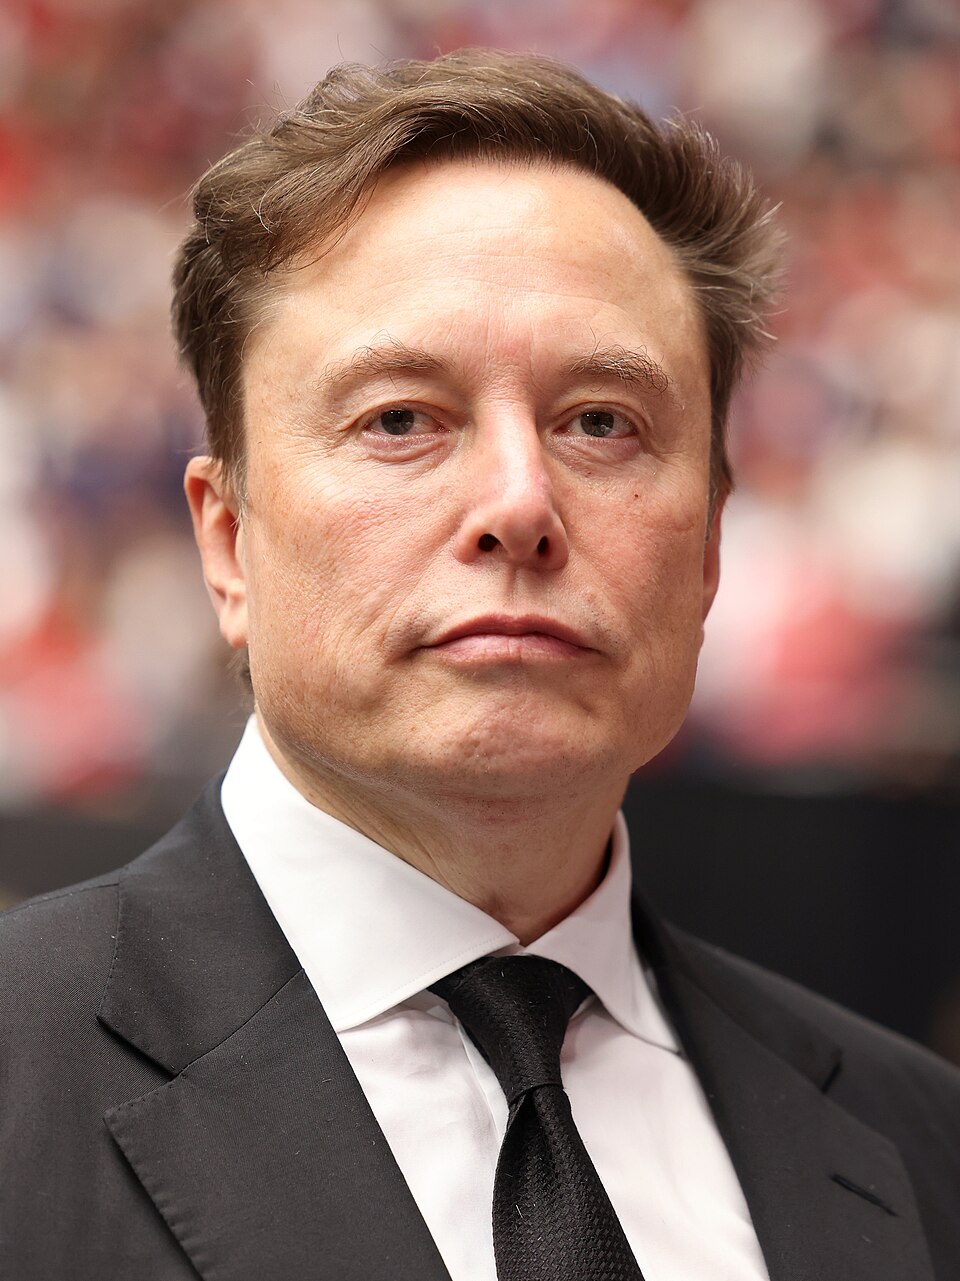
Elon MuskxAI'ın kurucusu (Grok)
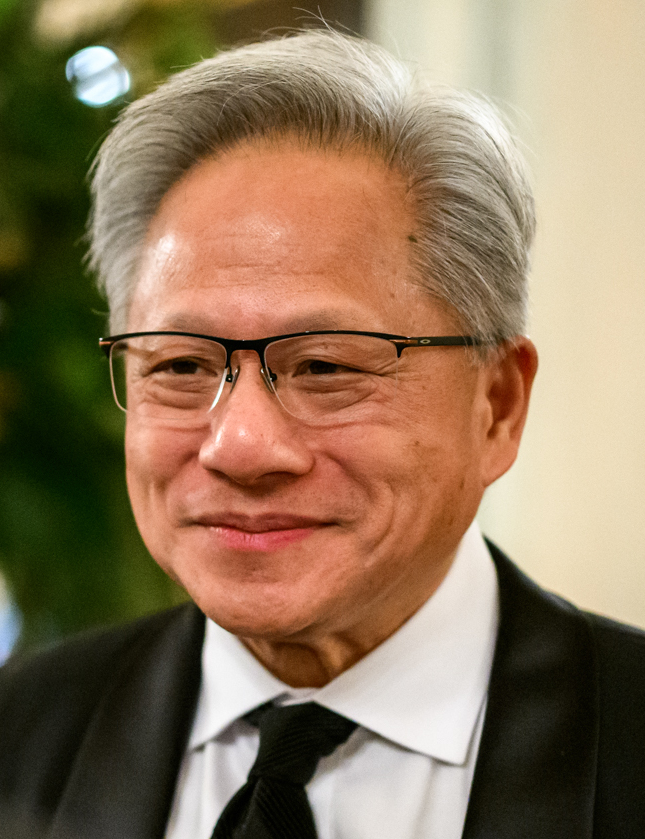
Jensen HuangNvidia'nın kurucusu ve yöneticisi
Fotoğraflar: Wikimedia Commons (Wikipedia'daki ilgili maddelerin görselleri)
ISINMA · LOGOYU TANI
TUZAK SORUHangisi bir LLM değildir?
ISINMA · LOGOYU TANI
Ürün ≠ Model
| Şirket | Ürün (uygulama) | Model (LLM) |
|---|---|---|
| OpenAI | ChatGPT | GPT-6 Astra, GPT-6.1 Sol, GPT-6 Luna |
| Anthropic | Claude uygulaması, Claude Code | Claude Fable 5.1, Opus 5.5, Sonnet 5.5, Haiku 4.5 |
| Gemini uygulaması, AI Studio | Gemini 3.8 Flash, Gemini 3.1 Pro, Gemma (açık) | |
| Microsoft | Copilot | Çoğunlukla OpenAI modelleri |
| — | Cursor, Perplexity | Başka şirketlerin modellerini kiralar |
Model adları Ekim 2026 itibarıyla. Kaynak: OpenAI, Anthropic, Google model sayfaları.
ISINMA · LOGOYU TANI
Aynı soru, üç uygulama
“LLM nedir? Tek cümleyle, lise öğrencisine anlatır gibi açıkla.”
ChatGPT
“LLM (Büyük Dil Modeli), çok miktarda metin okuyarak dili öğrenen ve sorulara cevap verebilen, metin yazabilen bir yapay zekâ modelidir.”
Gemini
“… kelimelerin birbirini takip etme ihtimalini hesaplayarak … sohbet edebilen … çok gelişmiş bir yapay zeka programıdır.”
 Perplexity
“… çok miktarda metinden öğrenerek insan dilini anlayıp yeni metinler yazabilen bir yapay zekâdır.”
Cevaplar benzer ama aynı değil. Model adı (Flash-Lite) ve kaynak kutusu modelin değil, uygulamanın eklediği şeyler.
Ekran görüntüleri: chatgpt.com, gemini.google.com, perplexity.ai; 11 Ekim 2026.
LLM nedir?
Üç kelime, tek fikir: sıradaki parçayı tahmin et.
01 · LLM NEDİR?
Large Language Model
Büyük Dil Modeli
Üç kelimeyi sondan başa doğru açalım: önce model, sonra dil, en son büyük.
01 · LLM NEDİR?
Önce büyük resim
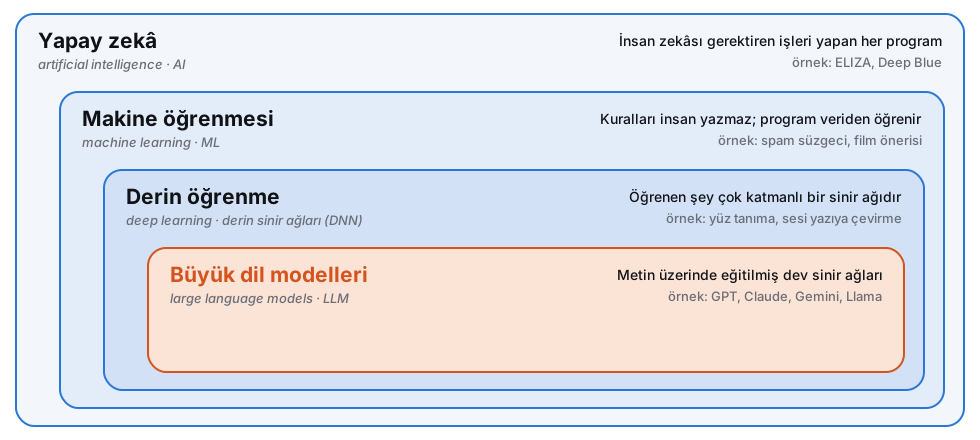
Her LLM bir derin sinir ağıdır; her yapay zekâ programı LLM değildir. Bugün “yapay zekâ” denince çoğunlukla en içteki kutu kastediliyor.
01 · LLM NEDİR?
HANGİ KUTU?Bunlar hangi kutuya girer?
| Program | En dar kutu |
|---|---|
| ELIZA (1966): kurallarla sohbet | Yapay zekâ (AI); öğrenme yok |
| Spam süzgeci: örneklerden öğrenir | Makine öğrenmesi (ML) |
| Telefonda yüz tanıma | Derin öğrenme (DL) |
| ChatGPT'nin içindeki GPT | Büyük dil modeli (LLM) |
01 · LLM NEDİR?
Model: dünyayı taklit eden küçük bir kopya
- Hava durumu modeli yarının havasını tahmin eder.
- Navigasyon varış saatini tahmin eder.
- Dil modeli sıradaki kelimeyi tahmin eder.
Bir model gerçeğin kendisi değildir. İyi bir tahmin makinesidir; bazen yanılır.
tahmin ≠ bilgi
Tahmin etmek, bilmek değildir. Model yanlış bir şeyi de aynı güvenle tahmin edebilir; buna 3. bölümde “halüsinasyon” adıyla döneceğiz.
01 · LLM NEDİR?
SİZ TAHMİN EDİNCümleyi tamamlayın
“Türkiye'nin başkenti Ankara”
Hepiniz aynı kelimeyi söylediniz. Kimse düşünmedi bile.
01 · LLM NEDİR?
SİZ TAHMİN EDİNPeki bu?
“Bugün hava çok ___”
Tek doğru cevap yok; bir olasılık dağılımı var. Değerler temsilidir.
01 · LLM NEDİR?
Dil modeli tam olarak bunu yapar
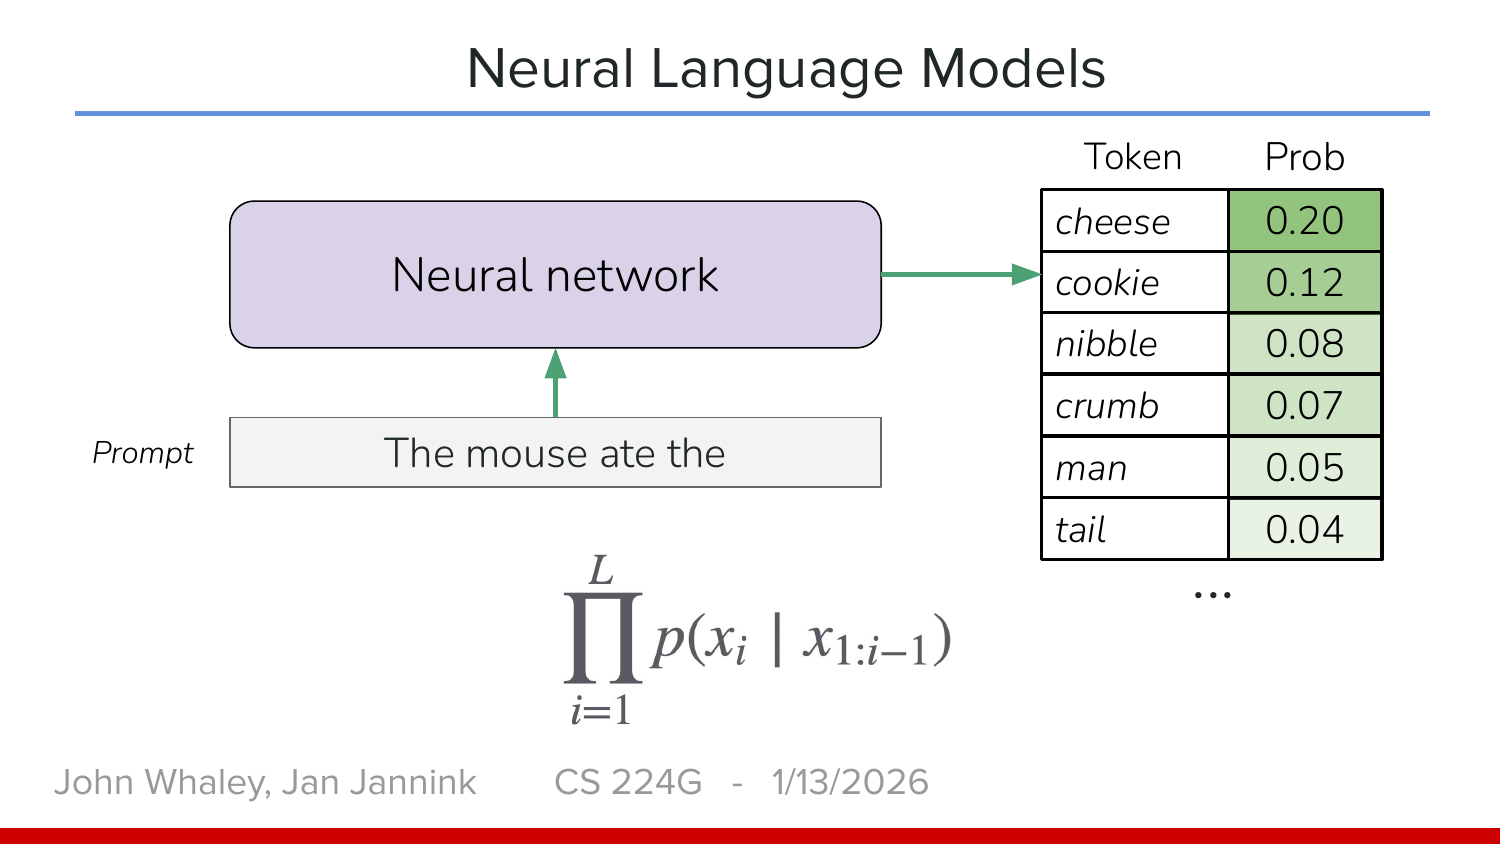
Girdi: “The mouse ate the” → Çıktı: sözlükteki her parça için bir olasılık.
01 · LLM NEDİR?
Telefonunuzda zaten bir dil modeli var
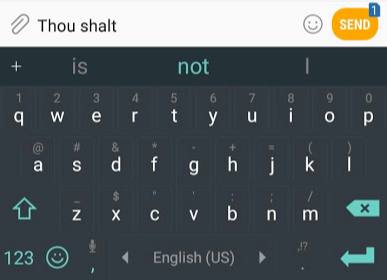
Klavyenin üstündeki öneri çubuğu küçük bir dil modelidir: yazdıklarınıza bakar, sıradaki kelimeyi tahmin eder.
LLM aynı işi yapar; farkı ölçek:
- Çok daha fazla metin okumuştur
- Çok daha uzun bir geçmişe bakar
- Tahmini art arda binlerce kez yapar
01 · LLM NEDİR?
SINIFTA DENEYİNTelefonunuzu çıkarın
- Bir mesaj kutusuna “Bugün okula” yazın
- Klavyenin önerdiği ortadaki kelimeye basın
- Yeni öneriden yine ortadakine basın; 10 kez tekrarlayın
Ortaya çıkan cümleyi yanınızdakiyle karşılaştırın. Anlamlı mı? Aynı mı?
Yaptığınız şey, bir dil modelinin metin üretme biçiminin ta kendisi: her adımda sıradaki kelimeyi seç, sona ekle, tekrarla.
01 · LLM NEDİR?
Büyük: ne kadar büyük?
Bu sayılar parametre sayısıdır. Güncel amiral gemisi modellerin parametre sayısı açıklanmıyor; açık modellerde yüz milyarlar ile trilyon arası.
Kaynak: OpenAI GPT-1/2/3 makaleleri. Çubuklar GPT-3'e oranlıdır; GPT-1 neredeyse görünmez.
01 · LLM NEDİR?
Parametre nedir?
Bir ses masasındaki ayar düğmelerini düşünün.
- Her düğme tek bir sayı tutar
- Eğitim, bu düğmeleri azar azar çevirme işidir
- Amaç, modelin tahminlerinin gerçek metne benzemesidir
175 milyar düğmeyi kimse elle çevirmiyor. Bunu bir algoritma yapıyor; 2. bölümde göreceğiz.
175.000.000.000
GPT-3'ün düğme sayısı. Saniyede bir düğme çevirseniz 5.500 yıl sürerdi.
01 · LLM NEDİR?
Kutunun içi: sinir ağı (neural network)
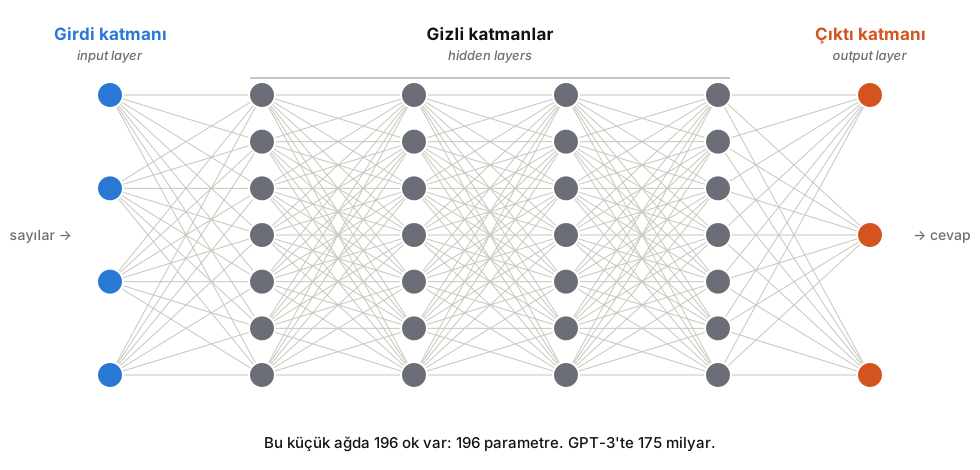
Daireler düğüm, çizgiler bağlantı. Sıra sıra dizilmiş dairelere katman (layer) denir. Sayılar soldan girer, sağdan çıkar.
01 · LLM NEDİR?
SİZ HESAPLAYINTek bir düğümde ne olur?
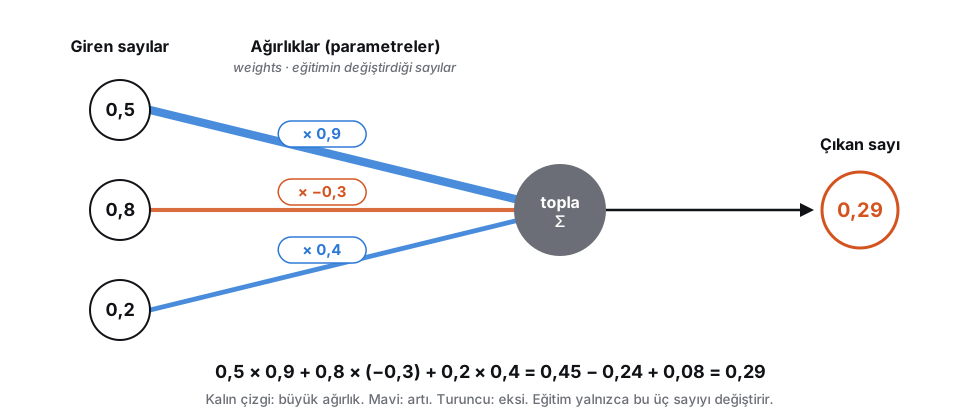
Çarp ve topla; hepsi bu. Çizgilerin üstündeki sayılar ağırlık (weight) ya da parametre: her biri bir ayar düğmesi.
01 · LLM NEDİR?
Son küçük adım: aktivasyon fonksiyonu (activation function)
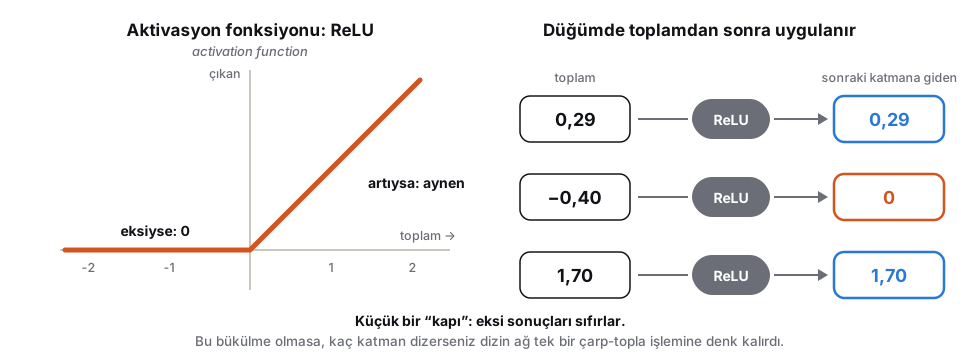
Her düğüm: çarp, topla, kapıdan geçir. En yaygın kapı ReLU: eksiyse 0, artıysa aynen. Bu küçük bükülme olmasa yüz katman, tek katmandan farksız olurdu.
01 · LLM NEDİR?
Derin (deep) = çok katman
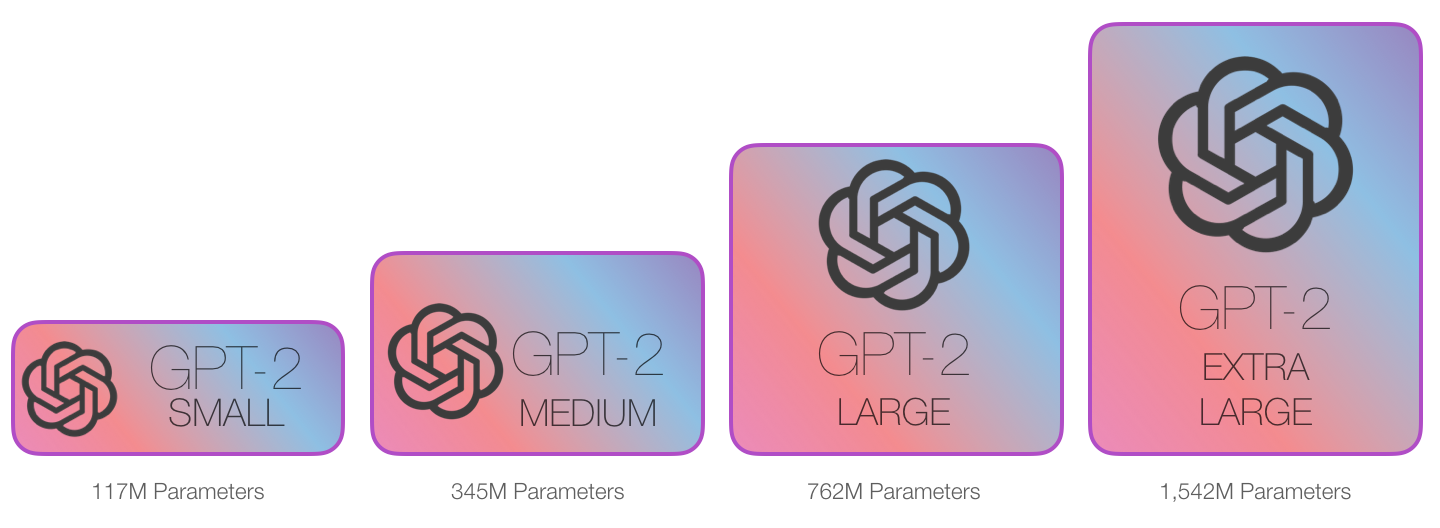
Aynı yapıyı çok daha fazla daireyle, üst üste onlarca katman (layer) hâlinde kurarsanız buna derin sinir ağı denir.
Şekil: aynı modelin (GPT-2) dört boyutu. Kutu büyüdükçe düğme sayısı artıyor.
Görsel: Jay Alammar, The Illustrated GPT-2
01 · LLM NEDİR?
DÜŞÜNÜNGözünüz bağlı, dağda en alçak noktayı arıyorsunuz. Ne yaparsınız?
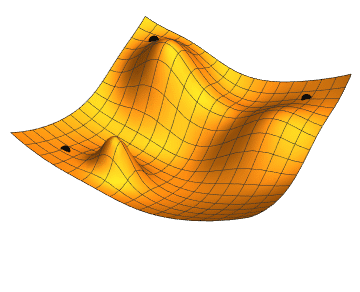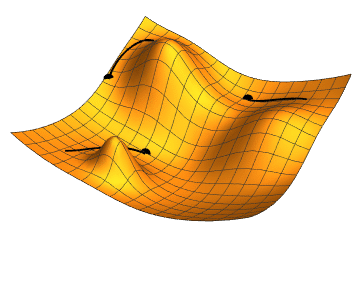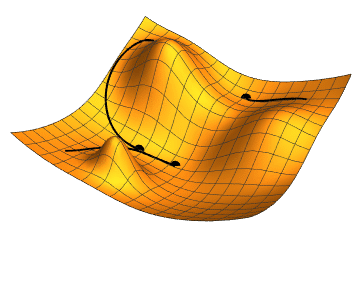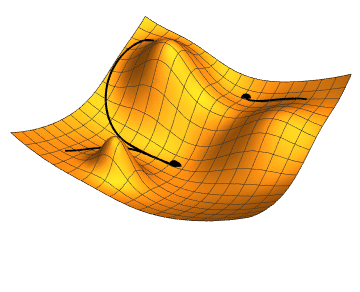
Ayağınızla eğimi yoklar, aşağı doğru küçük bir adım atarsınız. Tekrar yoklarsınız.
Bu benzetmede arazinin yüksekliği modelin hatasıdır; bulunduğunuz yer de düğmelerin o anki ayarı. En alçak nokta, hatanın en az olduğu ayardır.
Bu yöntemin adı gradyan inişi (gradient descent).
01 · LLM NEDİR?
Eğitim (training): düğmeleri azar azar çevirmek
↻ Milyarlarca kez
Kimse 175 milyar düğmeyi elle ayarlamıyor.
01 · LLM NEDİR?
Eğitimden önce, eğitimden sonra
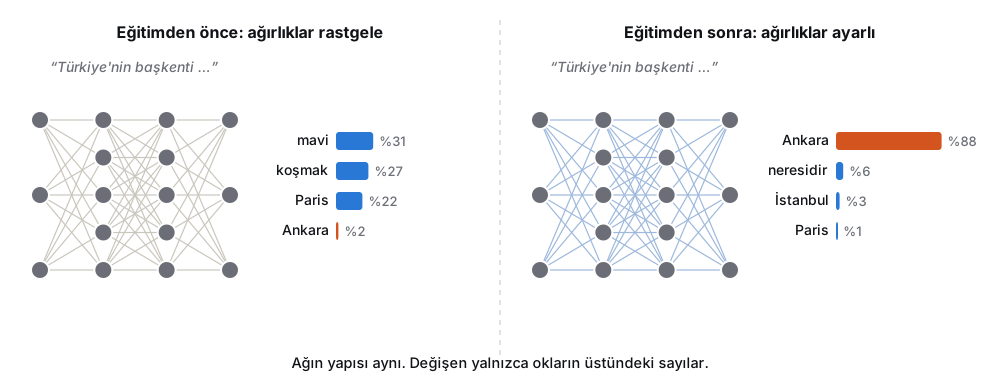
Ağın yapısı aynı. Değişen yalnızca çizgilerin üstündeki sayılar.
01 · LLM NEDİR?
Sinir ağından dil modeline
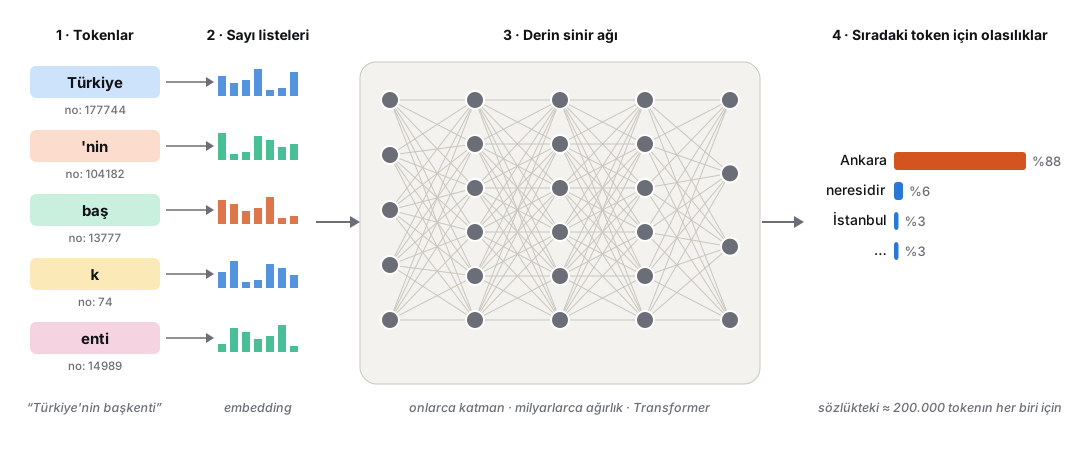
“Sıradaki kelimeyi tahmin eden program” ile “milyarlarca düğmeli sinir ağı” aynı şey: biri ne yaptığını, diğeri neyden yapıldığını söyler.
Token bölünmesi ve numaralar gerçek (o200k_base); olasılıklar temsili.
01 · LLM NEDİR?
Özetle…
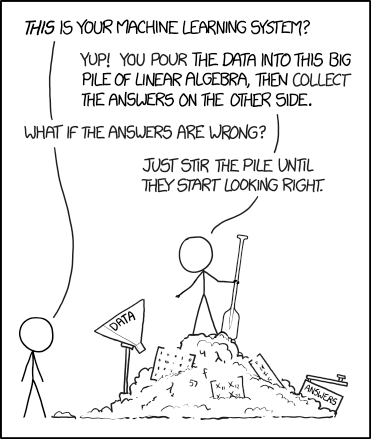
“Ya cevaplar yanlışsa?” — “Doğru görünene kadar yığını karıştırıyorsun.”
Randall Munroe, xkcd 1838: Machine Learning
01 · LLM NEDİR?
Sinir ağları, çizimlerle (19 dk)
3Blue1Brown, “But what is a neural network?” · devamı: “Gradient descent, how neural networks learn”
01 · LLM NEDİR?
BU KİM?Bu ünitede adını sık duyacaksınız
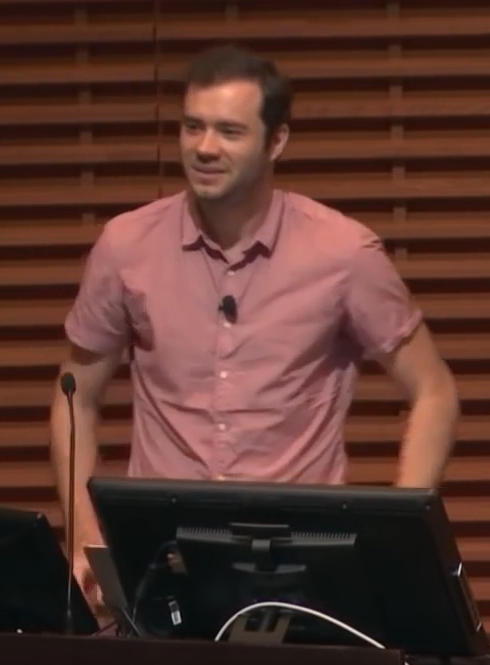
Andrej Karpathy
- OpenAI'ın kurucu ekibinden araştırmacı
- Tesla'da otonom sürüş yapay zekâsının eski yöneticisi
- Bu konuları en iyi anlatan eğitmenlerden; videoları ücretsiz
- “Vibe coding” terimini ortaya atan kişi (2025)
Fotoğraf: Wikimedia Commons · videoları: karpathy.ai/llm-course

01 · LLM NEDİR?
Bir LLM aslında iki dosyadır
1 · Parametre dosyası
İçinde yalnızca sayılar olan, yüzlerce gigabaytlık bir dosya. Modelin bütün “bilgisi” buradadır.
2 · Çalıştırma kodu
Birkaç yüz satırlık küçük bir program. Bu sayıları çarpıp toplayarak sıradaki parçayı üretir.
İnternetin kayıplı sıkıştırılmış bir kopyası gibi düşünün: zip dosyası, ama açınca aslının tıpatıp aynısı çıkmıyor.Andrej Karpathy, “Intro to Large Language Models” (2023) — serbest çeviri
01 · LLM NEDİR?
Tek cümleyle
LLM, çok büyük miktarda metinden öğrenerek sıradaki parçayı tahmin eden ve bunu art arda yaparak metin üreten bir sinir ağıdır.
Soru cevaplamak, kod yazmak, çeviri yapmak: hepsi bu tek becerinin yan ürünü.
01 · LLM NEDİR?
LLM ne değildir?
Veritabanı
Bilgiyi satır satır saklamaz; kalıpları saklar.
Arama motoru
Kendi başına internete bakmaz.
Hesap makinesi
Sayıyı hesaplamaz, tahmin eder.
Kişi
Niyeti ve duygusu yoktur. Özel bir ayar yoksa bir sohbetten diğerine sizi hatırlamaz.
Bugünkü uygulamalar bu eksikleri araçlarla kapatır. Modelin kendisi hâlâ bir tahmin makinesidir.
01 · LLM NEDİR?
8 dakikada özet
3Blue1Brown, “Large Language Models explained briefly” — youtube.com/watch?v=LPZh9BOjkQs · Türkçe altyazı açılabilir.
Tarihçe
Fikir 70 yıllık; asıl sıçrama son birkaç yılda oldu.
02 · TARİHÇE
TAHMİNChatGPT ne zaman yayımlandı?
02 · TARİHÇE
BU KİM?1950: “Makineler düşünebilir mi?”
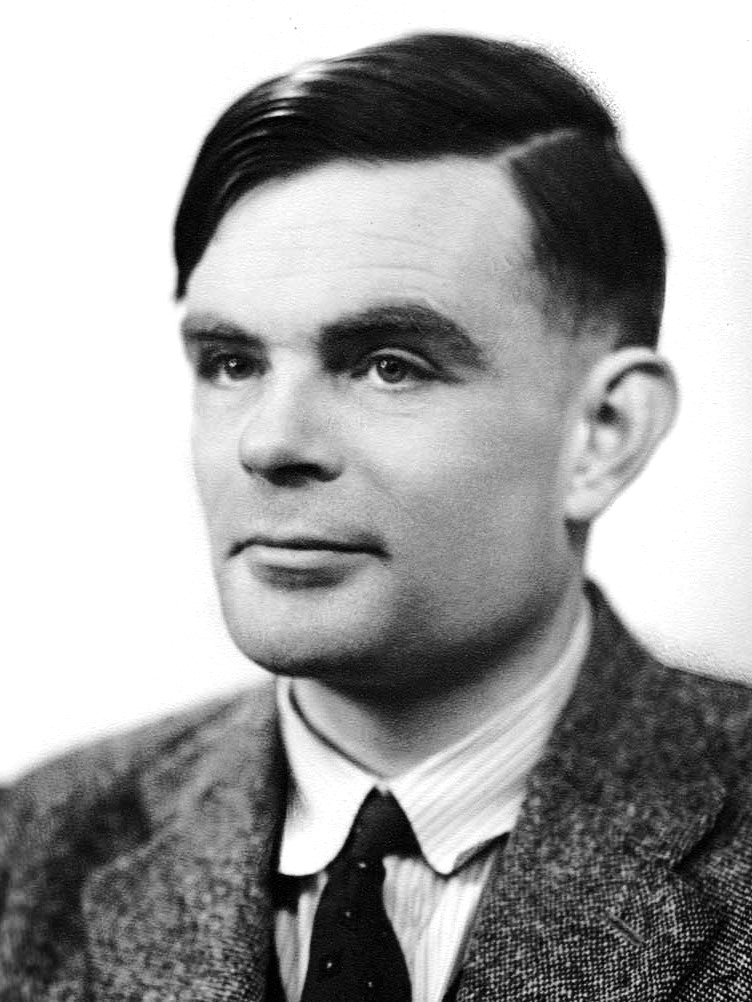
Alan Turing
İngiliz matematikçi (1912–1954). Modern bilgisayar biliminin kurucularından; İkinci Dünya Savaşı'nda Alman şifrelerinin kırılmasında rol aldı.
Turing testi: yazışarak konuştuğunuz karşı tarafın insan mı makine mi olduğunu ayırt edemiyorsanız, o makineye “düşünüyor” denebilir mi?
Fotoğraf: Wikimedia Commons

02 · TARİHÇE
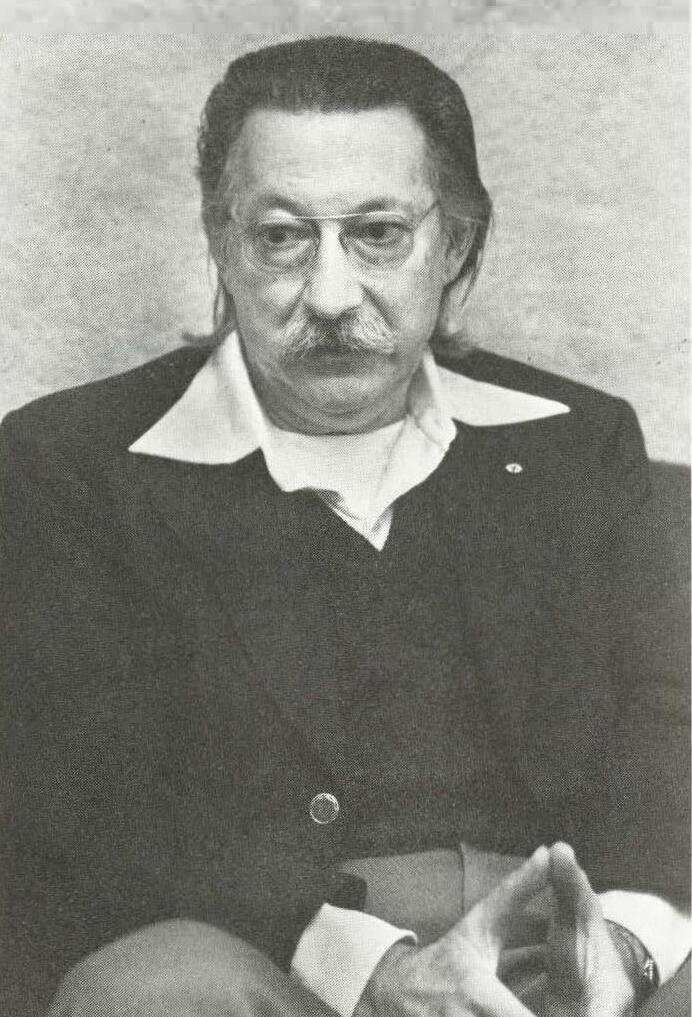
1966: ELIZA
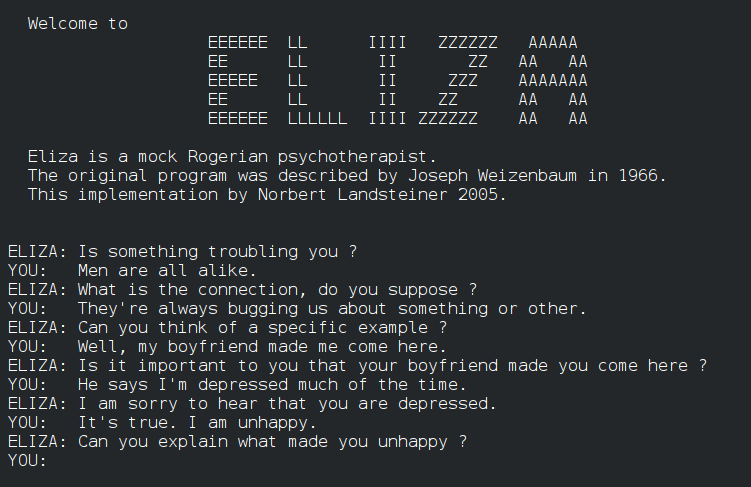
MIT'de Joseph Weizenbaum'un yazdığı, ilk sohbet programlarından biri.
- Yazılanı anlamıyordu
- Cümlenizdeki bir kelimeyi alıp soruya çeviriyordu
- Yine de insanlar ona içini döktü
İnsanın makineye anlam yükleme eğilimine bugün hâlâ ELIZA etkisi deniyor.
02 · TARİHÇE
ELIZA nasıl “konuşuyordu”?
| Cümlede şu varsa | Şunu söyle |
|---|---|
| “annem”, “babam” | “Bana ailenizden bahsedin.” |
| “Ben … hissediyorum” | “Neden … hissediyorsunuz?” |
| hiçbiri | “Devam edin.” |
Program birkaç yüz satırlık kuraldan ibaretti. Yazılanı anlamıyor, yeni bir şey de öğrenmiyordu.
Weizenbaum'un sekreteri, programla konuşurken ondan odadan çıkmasını istedi. Weizenbaum bundan o kadar rahatsız oldu ki ömrünün kalanında yapay zekâyı eleştirdi.
Akıcı konuşan bir makinenin bizi anladığını sanmamıza ELIZA etkisi denir.
02 · TARİHÇE
1997: bilgisayar, satrançta dünya şampiyonunu yendi
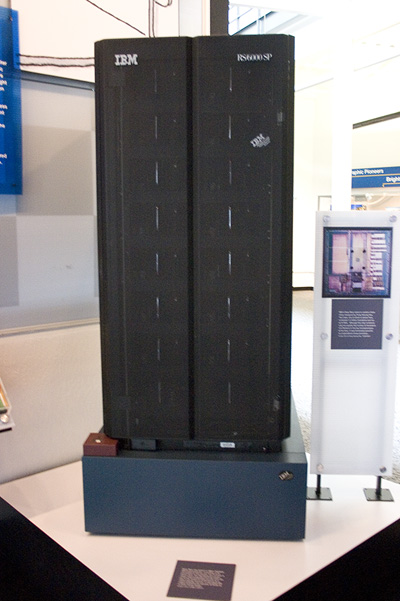

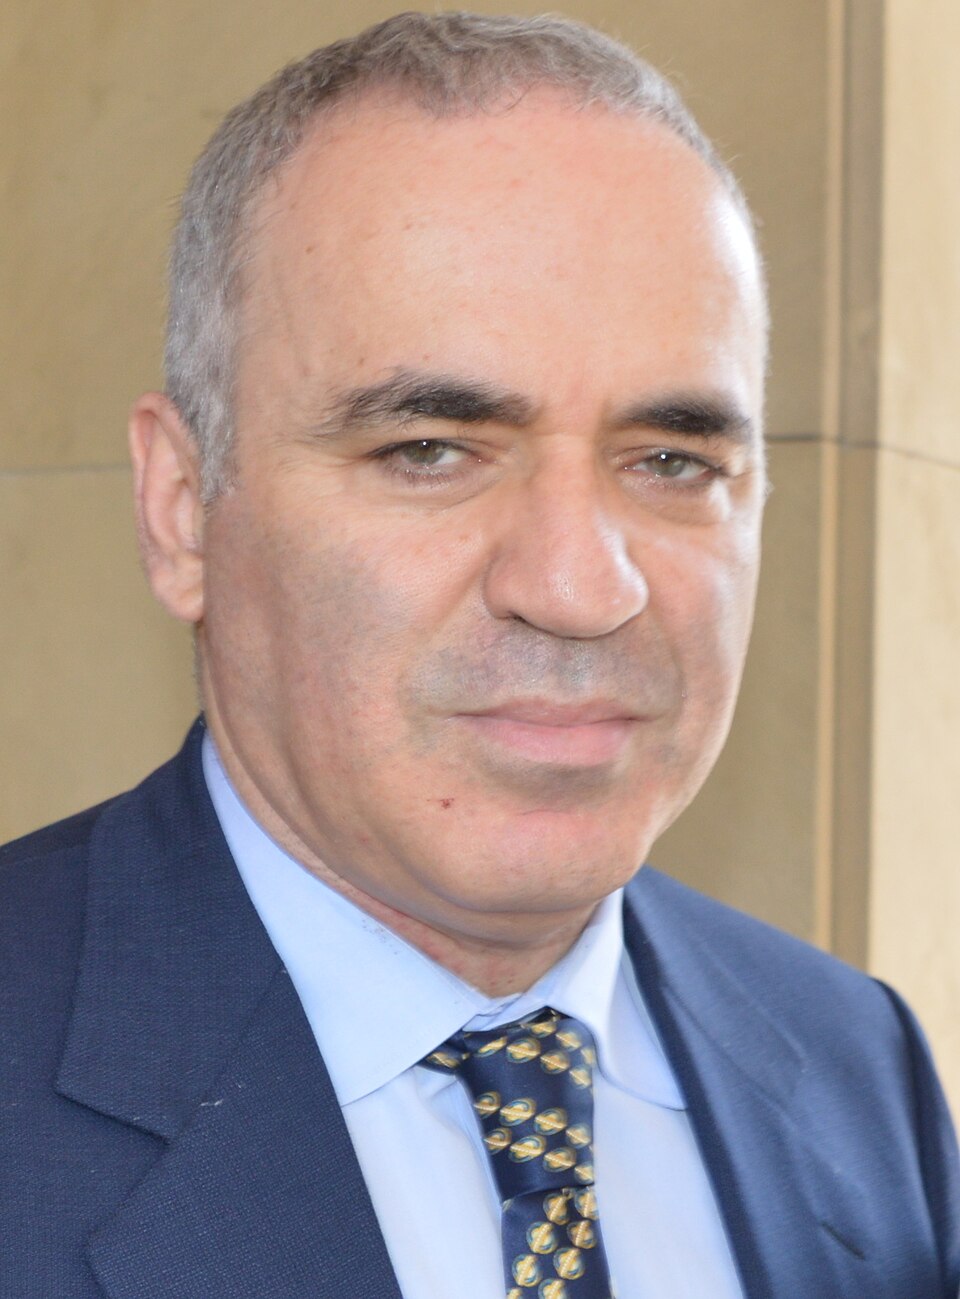
Garry Kasparov: 1985'ten 2000'e kadar dünya satranç şampiyonu. Pek çok kişiye göre tarihin en iyi oyuncusu.
Deep Blue: IBM şirketinin yalnızca satranç oynamak için yaptığı bilgisayar.
Mayıs 1997'de altı oyunluk bir maç yaptılar. Maçı Deep Blue kazandı: 3,5'e 2,5.
02 · TARİHÇE
TAHMİNKasparov'u yenen bu bilgisayar bir cümle kurabiliyor muydu?
Hayır. Deep Blue “zeki” değildi ve hiçbir şey öğrenmiyordu. Her hamleden önce saniyede 200 milyon olası hamleyi tek tek deniyor, en iyi sonucu vereni seçiyordu.
Düşünmek yerine bütün olasılıkları hızla denemeye kaba kuvvet (brute force) denir. Satrançta işe yarar; dilde yaramaz, çünkü kurulabilecek cümlelerin sayısı sonsuzdur.
02 · TARİHÇE
TARTIŞIN2012: “Go’da bilgisayarlar hâlâ en iyi insanlara yeniliyor”
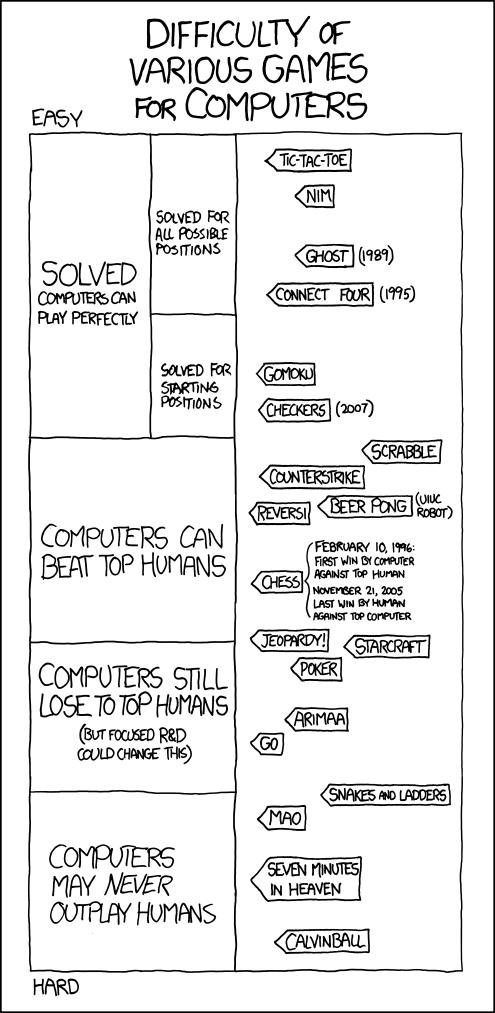
Bu çizelge 2012’den. Satranç yukarıda, Go aşağıda.
Dört yıl sonra AlphaGo dünya düzeyinde bir Go oyuncusunu yendi.
Bugün hangi “bilgisayar bunu asla yapamaz” cümlesine şüpheyle bakardınız?
xkcd 1002: Game AIs, CC BY-NC 2.5
02 · TARİHÇE
2012: ekran kartları sahneye çıkıyor
Fotoğraftaki nesneyi tanıma yarışması (ImageNet):
AlexNet derin bir sinir ağıydı ve oyun bilgisayarlarındaki iki ekran kartında (GPU) eğitilmişti.
Neden ekran kartı?
Oyunda milyonlarca pikseli aynı anda hesaplamak için tasarlandı. Sinir ağı eğitimi de aynı türden bir iştir: çok sayıda basit çarpma işleminin aynı anda yapılması gerekir.
O günden beri yapay zekâ modelleri ekran kartlarında eğitiliyor. Bu kartların en büyük üreticisi Nvidia da bu sayede dünyanın en değerli şirketlerinden biri oldu.
Krizhevsky, Sutskever, Hinton, “ImageNet Classification with Deep Convolutional Neural Networks” (2012)
02 · TARİHÇE
BU KİM?Derin öğrenmenin arkasındaki isimler
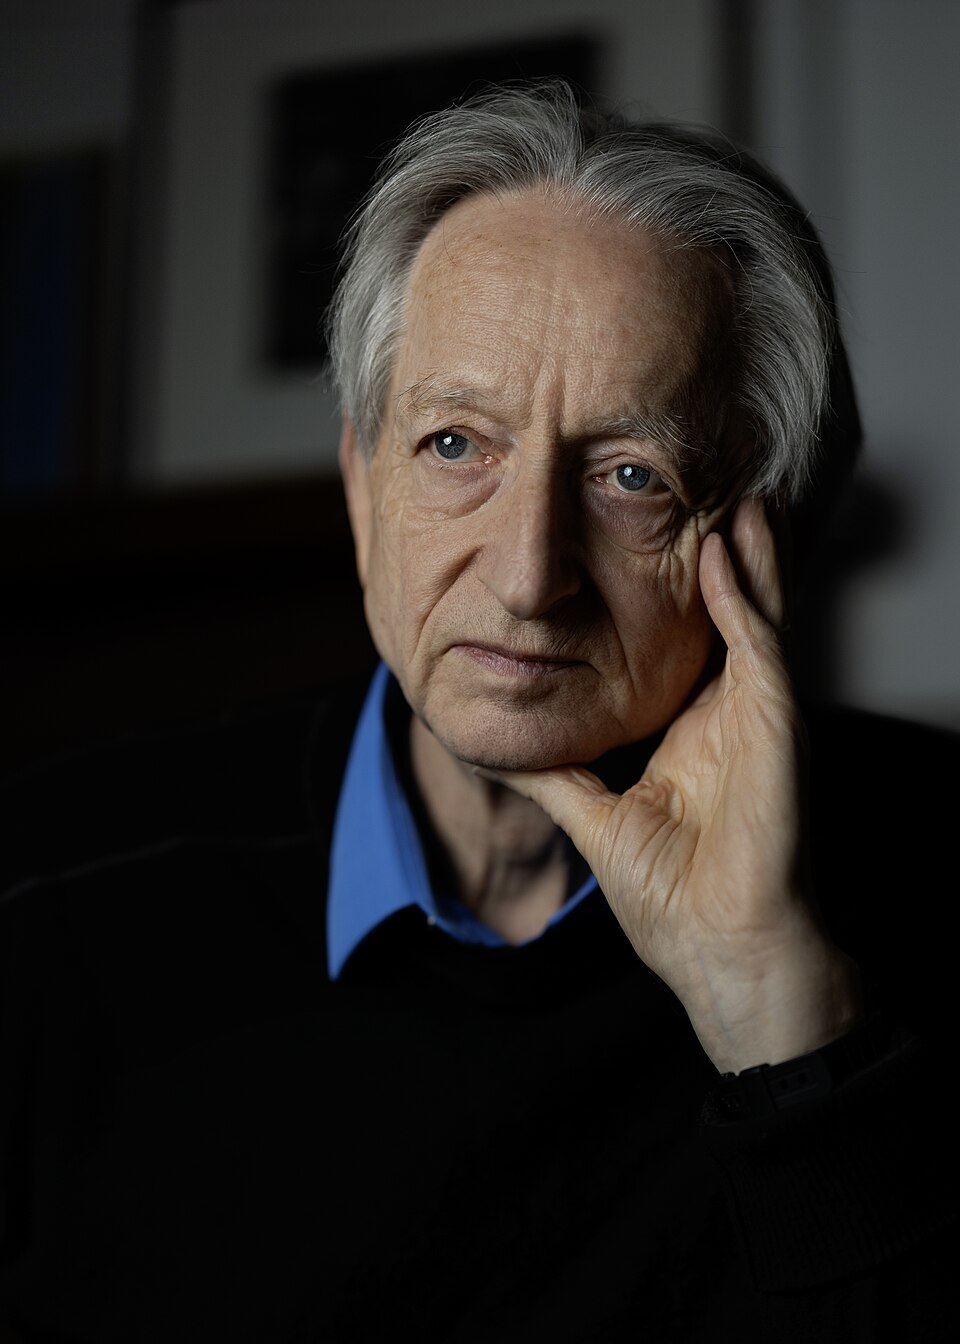
Geoffrey HintonSinir ağlarının öncüsü; AlexNet ekibinin hocası. 2024 Nobel Fizik Ödülü
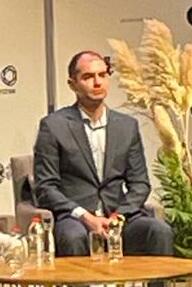
Ilya SutskeverAlexNet'in ortak yazarı; sonra OpenAI'ın kurucu ortağı ve baş bilimcisi
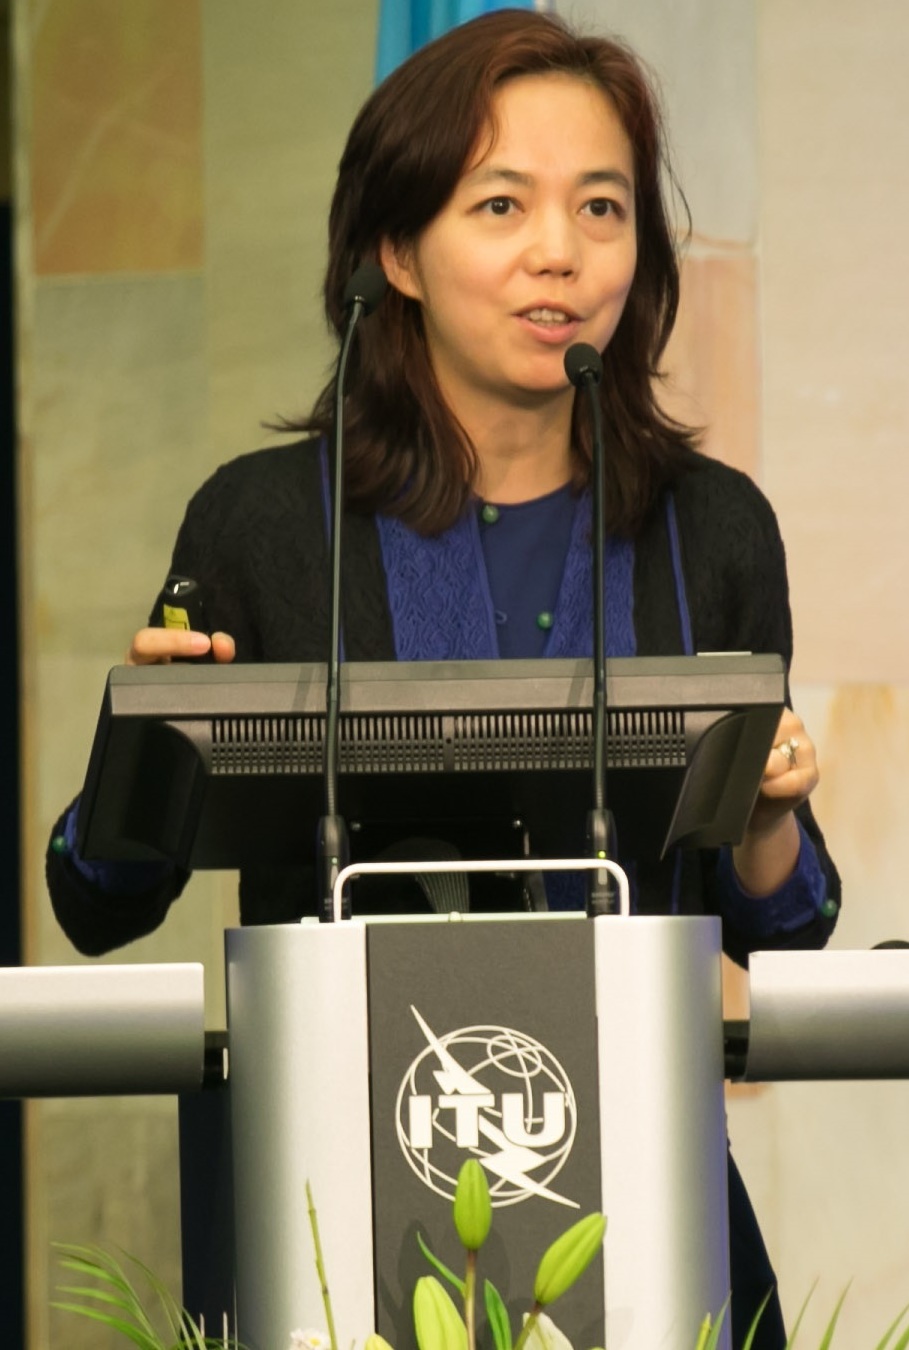
Fei-Fei LiYarışmanın dayandığı ImageNet fotoğraf arşivini kurdu
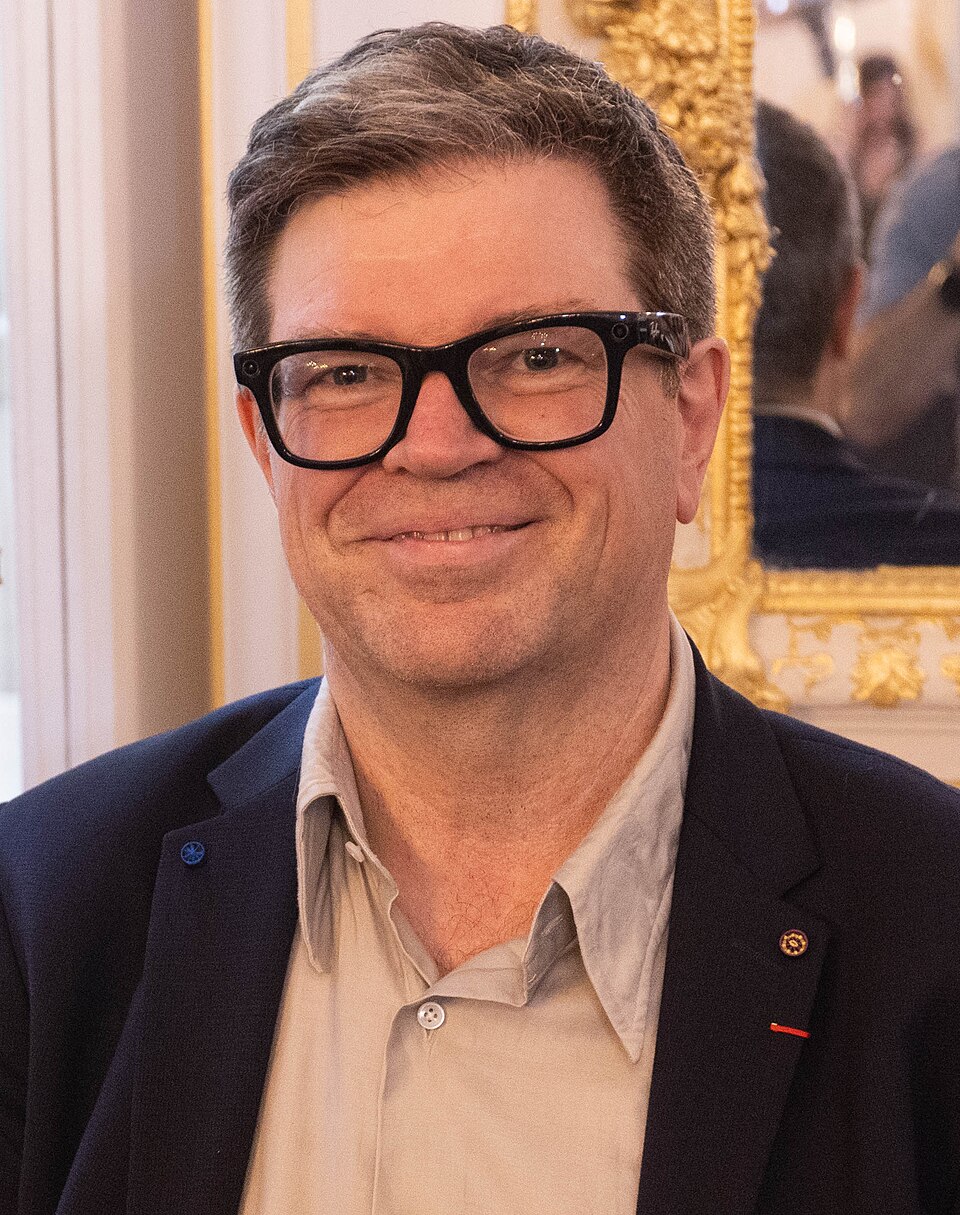
Yann LeCunGörüntü tanıyan sinir ağlarının öncüsü; uzun yıllar Meta'nın baş bilimcisi
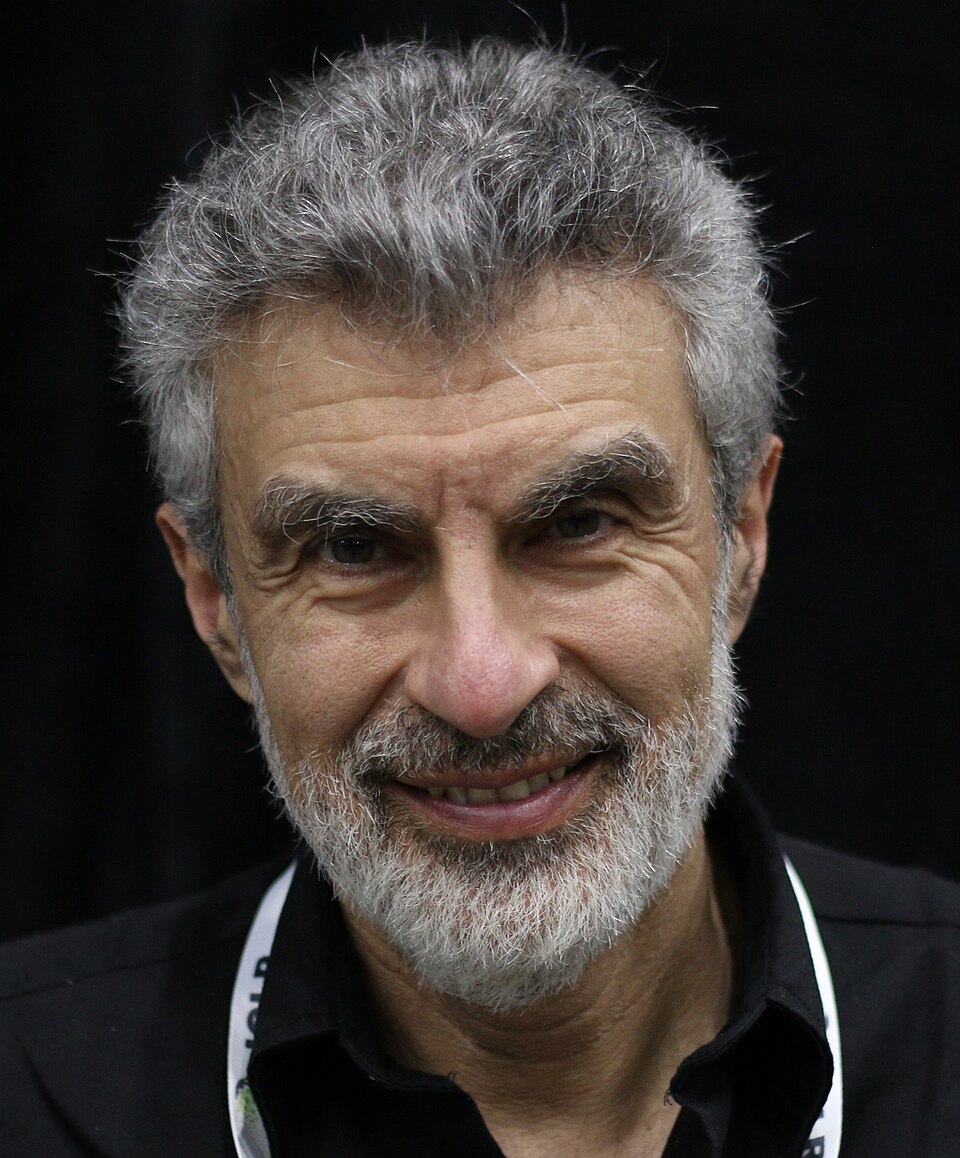
Yoshua BengioHinton ve LeCun ile 2018 Turing Ödülü'nü paylaştı
AlexNet'in üç yazarı: Alex Krizhevsky, Ilya Sutskever ve hocaları Geoffrey Hinton. Turing Ödülü, bilgisayar biliminin Nobel'i sayılır.
Fotoğraflar: Wikimedia Commons (Wikipedia'daki ilgili maddelerin görselleri)
02 · TARİHÇE
Uzun bekleyiş
- 1950 Alan Turing: “Makineler düşünebilir mi?”
- 1966 ELIZA: kural tabanlı sohbet
- 1997 Deep Blue satrançta Kasparov'u yener; ama tek cümle kuramaz
- 2012 AlexNet: derin sinir ağları görüntü tanımada büyük fark atar; ekran kartları önem kazanır
- 2013 word2vec: kelimeler sayıya dönüşür
- 2017 Transformer: “Attention Is All You Need”
02 · TARİHÇE
2013: kelimeler koordinat olur
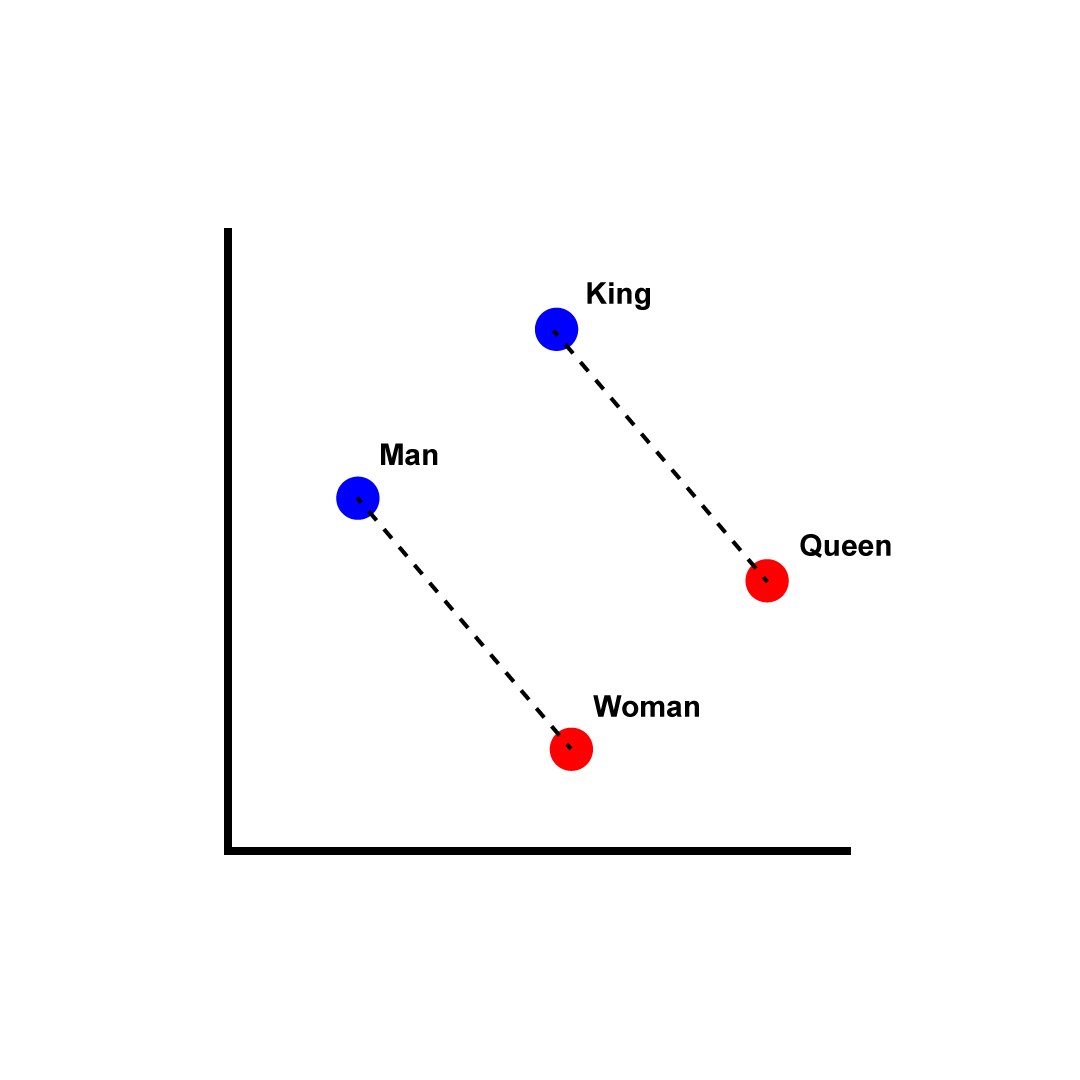
kral − erkek + kadın ≈ kraliçe
Yöntemi geliştiren: Tomáš Mikolov ve Google'daki ekibi.
Her kelimeye bir sayı listesi verilir; bu listeye embedding denir. Anlamca yakın kelimelerin sayıları da birbirine yakındır.
Bugünkü modellerde her parça için binlerce sayıdan oluşan bir liste tutulur.
02 · TARİHÇE
Kelimelerle toplama çıkarma: kendiniz görün
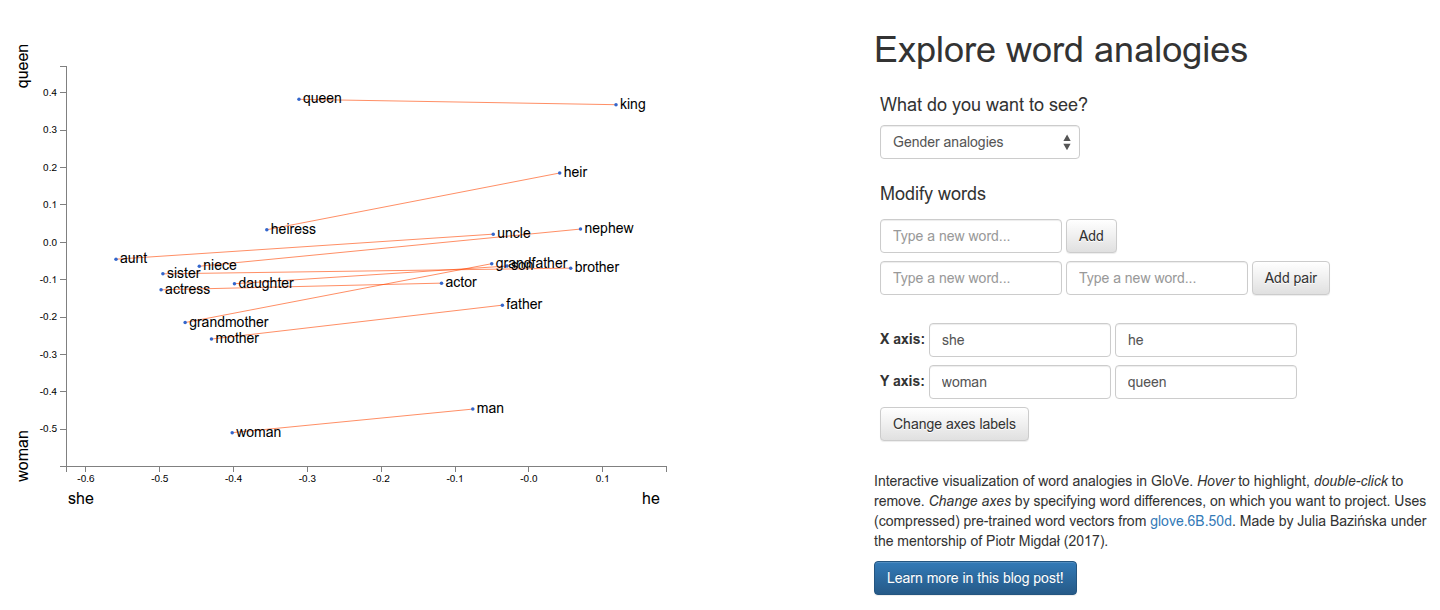
Yatay eksen: “she” (kadın) → “he” (erkek). Her çizgi bir çifti bağlıyor: teyze–amca, kraliçe–kral… Çizgiler paralel: “cinsiyet” farkı hep aynı yönde. Kendi kelime çiftinizi ekleyebilirsiniz.
lamyiowce.github.io/word2viz · hesap makinesi gibi denemek için: Word to Vec JS Demo · nokta bulutu: Embedding Projector
02 · TARİHÇE
TAHMİN EDİN“computer” kelimesinin en yakın komşuları hangileri?
10 bin İngilizce kelimelik word2vec haritasında computer (bilgisayar) kelimesine en yakın beş kelime sizce hangileri? Videoyu oynatmadan tahmin edin.
Embedding Projector, projector.tensorflow.org · kayıt: 11 Ekim 2026 · her kelime 200 sayılık bir liste; ekrandaki üç boyut onun sığdırılmış gölgesi
02 · TARİHÇE
SINIFTA OYNAYINSemantle Türkçe: gizli kelimeyi anlamından bulun
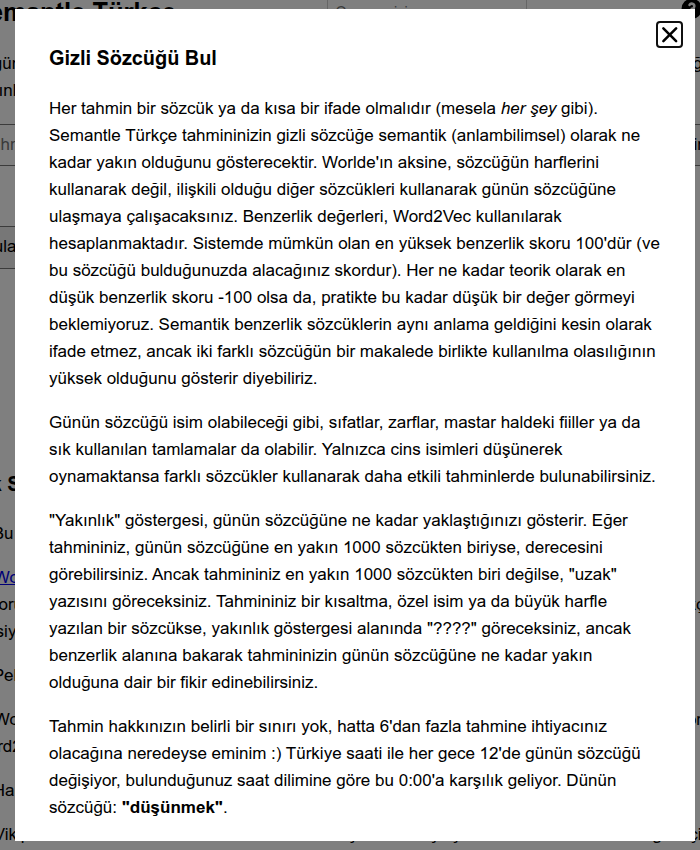
semantle.ozanalpay.com · her gün yeni bir kelime
02 · TARİHÇE
2017: her şeyi değiştiren makale
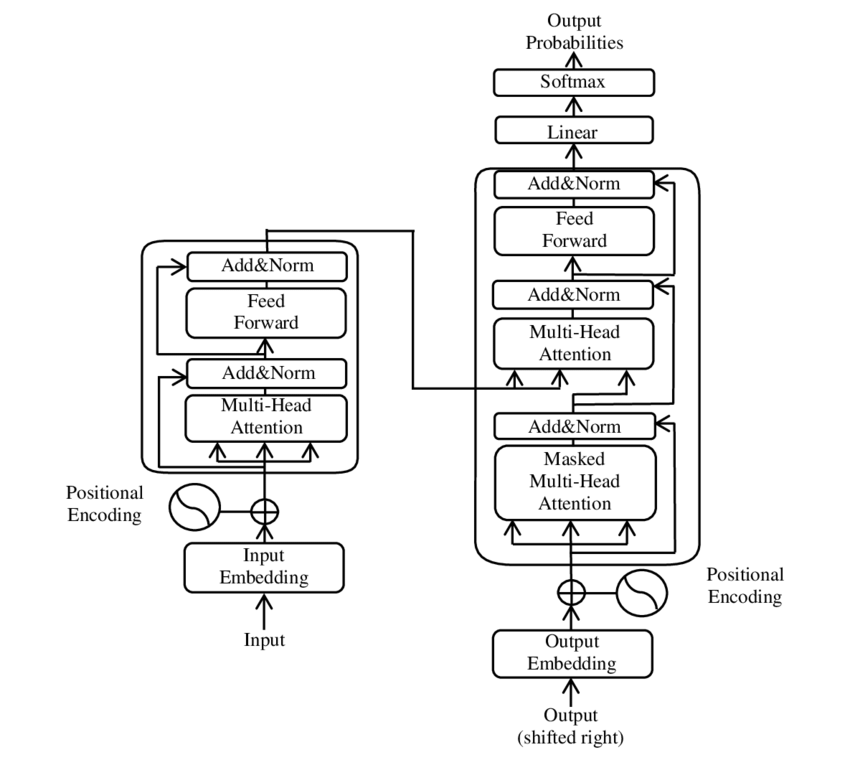
“Attention Is All You Need”
- Google'dan 8 araştırmacı
- Amaç: daha iyi makine çevirisi
- Fikir: her kelime, cümledeki tüm diğer kelimelere aynı anda baksın
- Sonuç: ekran kartlarında hızla eğitilebilen ve uzun metinde bağlamı kaybetmeyen bir tasarım
GPT'deki T harfi: Transformer.
02 · TARİHÇE
2018–2020: “daha büyüğünü yap” dönemi
- 2018 GPT-1 ve BERT: modeli önce bol miktarda ham metinle eğitme, sonra belirli bir işe uyarlama fikri
- 2019 GPT-2: OpenAI “kötüye kullanılabilir” diyerek tam modeli aylarca yayımlamadı
- 2020 GPT-3: 175 milyar parametre; birkaç örnek gösterince yeni iş öğreniyor
- 2021 GitHub Copilot: ilk yaygın yapay zekâ kod yardımcısı
Keşif: mimariyi değiştirmeden yalnızca büyütmek bile yeni yetenekler doğuruyor.
02 · TARİHÇE
30 Kasım 2022: ChatGPT
100 milyon kullanıcıya ulaşma süresi
Teknoloji yeni değildi (GPT-3.5). Yeni olan arayüzdü: bir sohbet kutusu.
02 · TARİHÇE
2023–2024: yarış başlıyor
- 2023 Şubat Meta, Llama'yı yayımlar: herkesin indirebildiği modeller dönemi başlar
- 2023 Mart GPT-4 ve Claude: avukatlık ve tıp sınavlarını geçen modeller
- 2024 Mayıs GPT-4o: metin, ses ve görüntü tek modelde
- 2024 Eylül o1: cevap vermeden önce “düşünen” ilk yaygın model
- 2024 Bağlam penceresi 1 milyon tokena çıkar (Gemini 1.5)
02 · TARİHÇE
İlk LLM'lerin soy ağacı
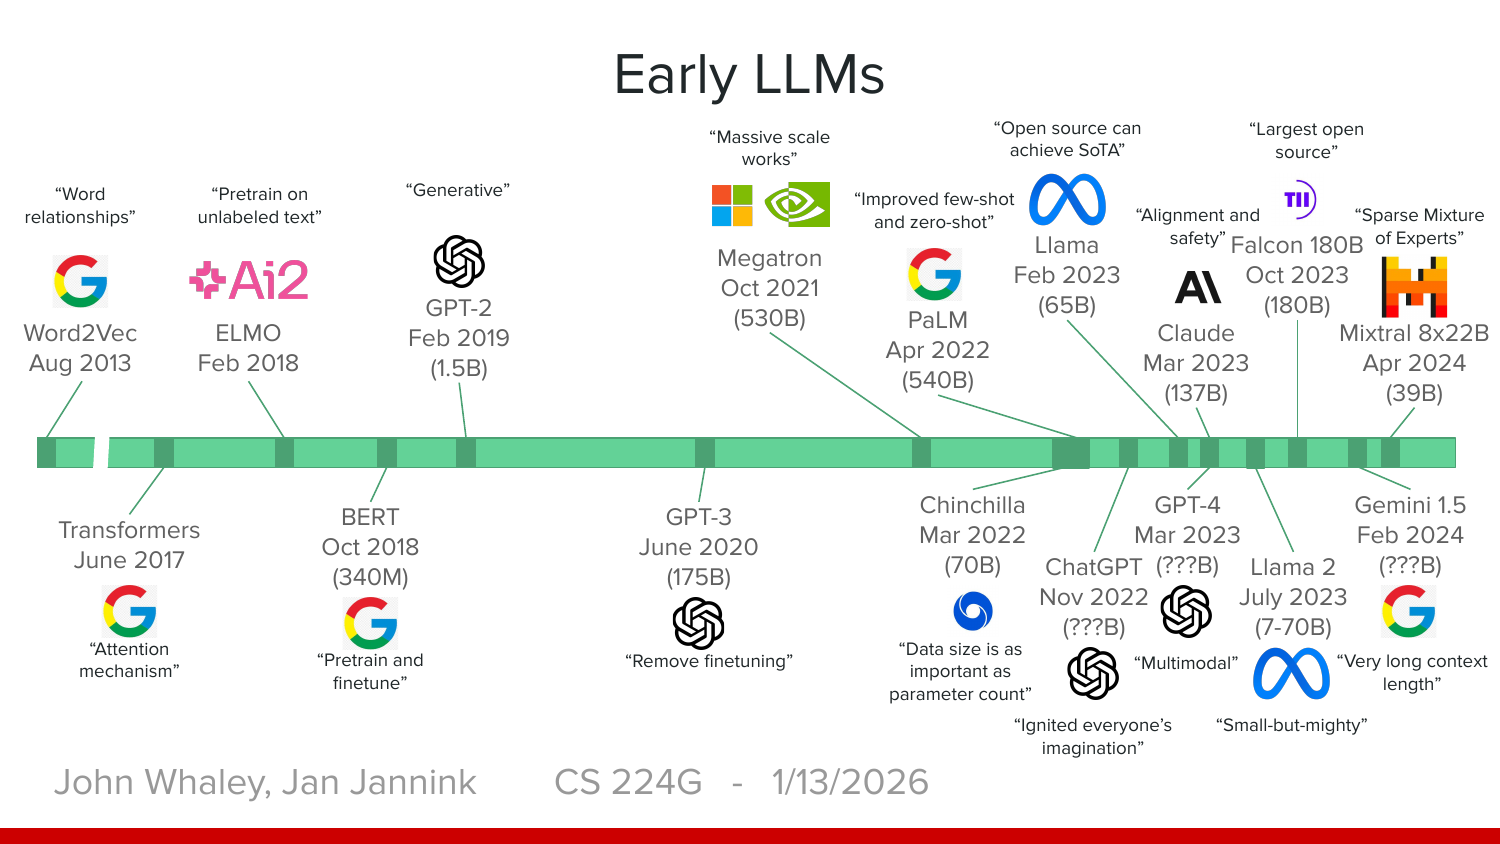
Görsel: Stanford CS224G 2026, 3. ders — Whaley & Jannink. Parantez içi: parametre sayısı.
02 · TARİHÇE
2025: DeepSeek şoku ve ajanlar
- Ocak DeepSeek R1: Çin'den, herkesin indirebildiği ve cevaptan önce “düşünen” bir model
- Şubat Claude Code: terminalde çalışan kodlama ajanı; “vibe coding” terimi doğar
- Ağustos GPT-5
- Yıl boyu Modeller saatlerce kendi başına çalışmaya başlar
≈ 589 milyar $
27 Ocak 2025'te Nvidia'nın bir günde kaybettiği piyasa değeri. Sebep: yatırımcılar, güçlü modellerin çok daha ucuza yapılabildiğini görünce pahalı çiplere talebin düşeceğinden korktu.
Kaynak: CNBC, 27 Ocak 2025.
02 · TARİHÇE
“Herkesin indirebildiği model” nerede durur?
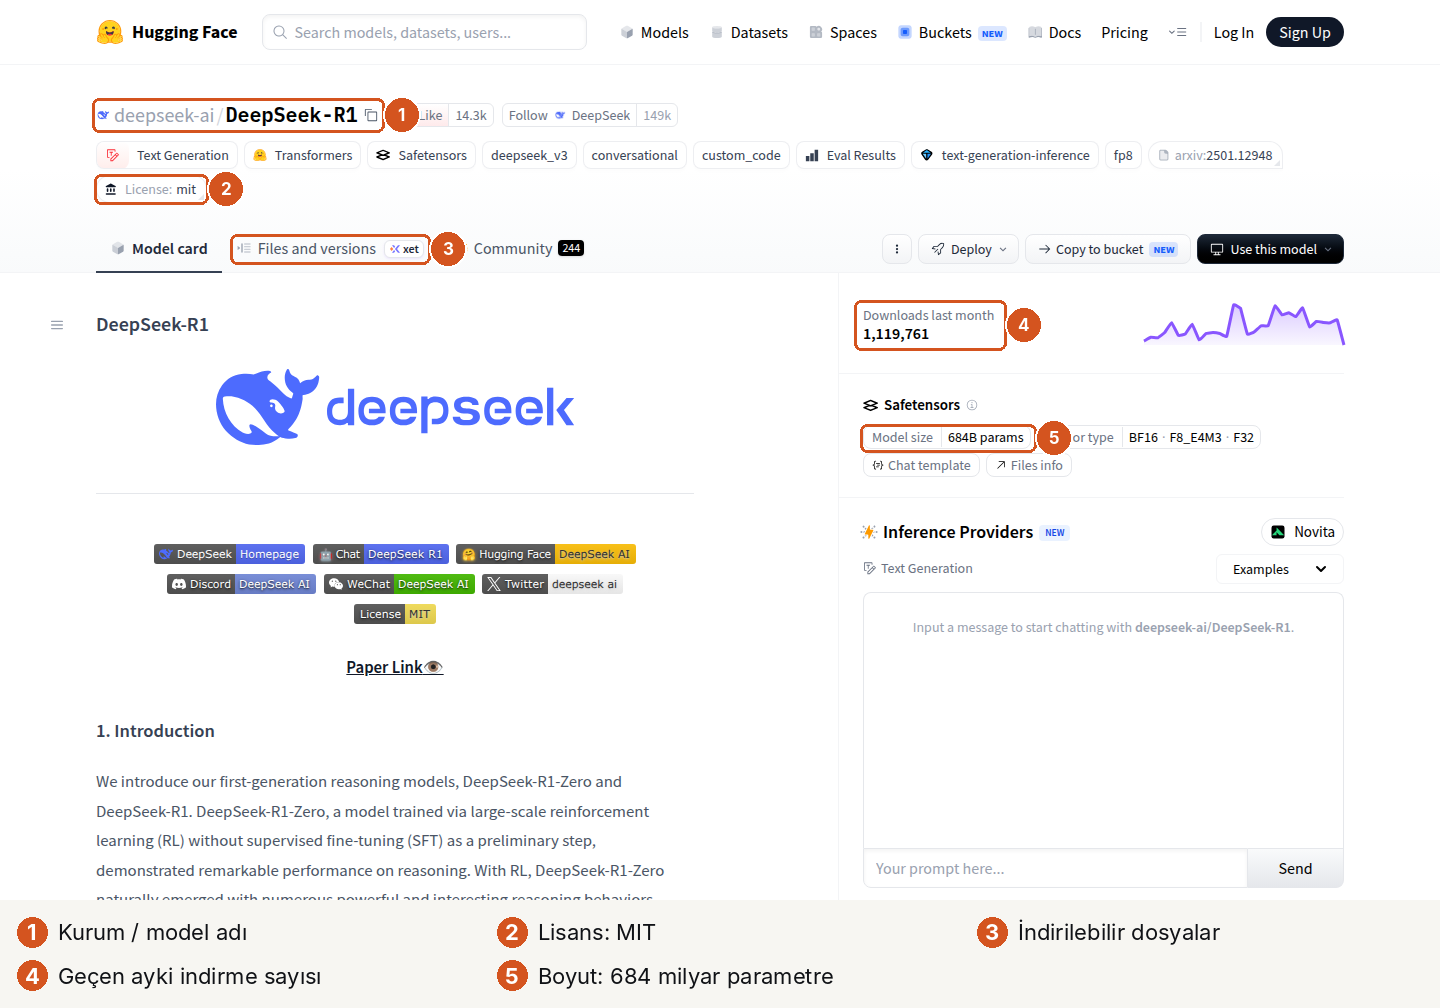
Hugging Face: açık modellerin paylaşıldığı site. Ekran görüntüsü: huggingface.co, 11 Ekim 2026.
02 · TARİHÇE
Bugün: Ekim 2026
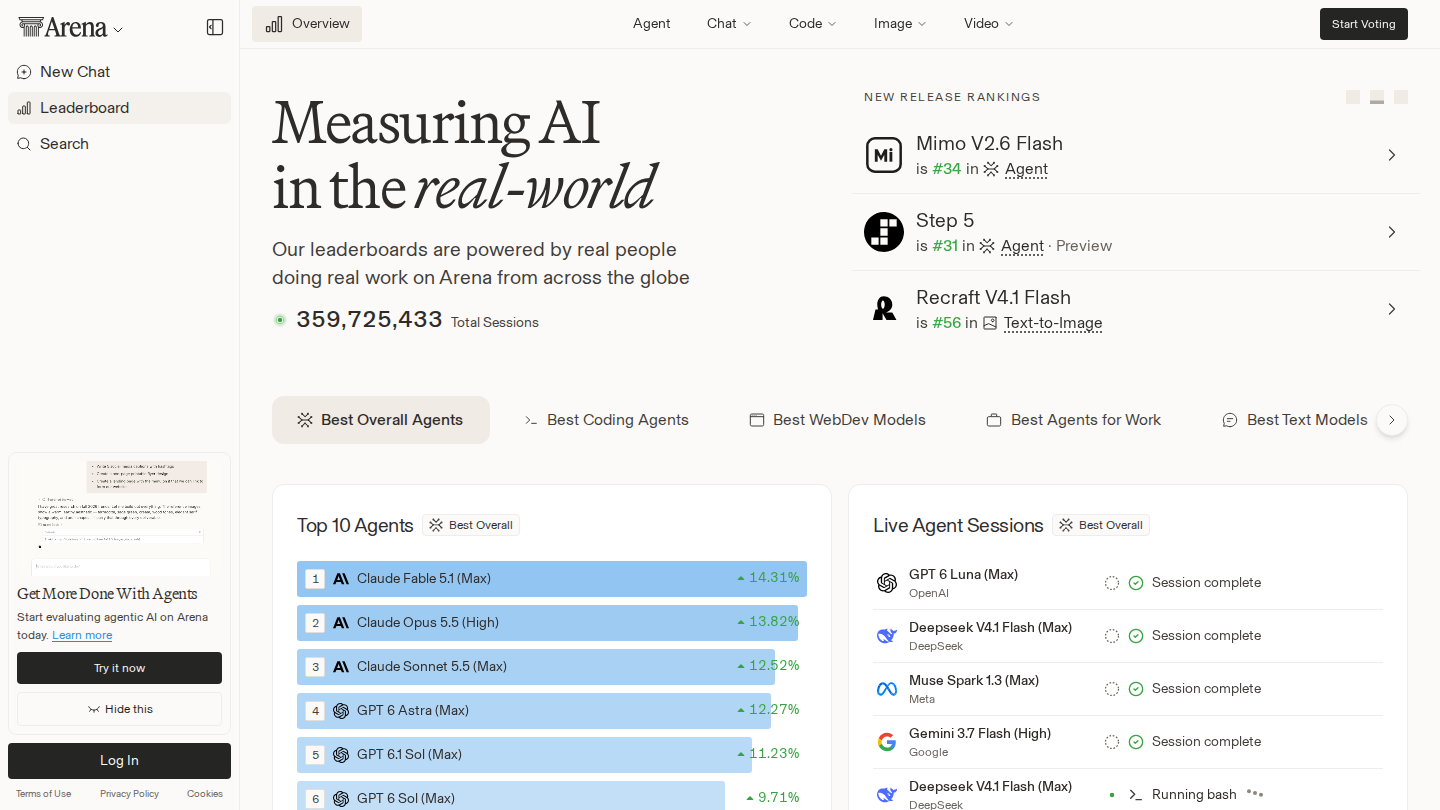
Ekran görüntüsü: lmarena.ai, 5 Ekim 2026. Sıralama haftadan haftaya değişir; derse gelmeden canlı sayfaya bakın.
02 · TARİHÇE
TARTIŞIN1525 puanlı model, 1507 puanlıdan daha mı iyi?
Rank Spread (3): 2. sıradaki modelin gerçek yeri 2. ile 10. arası.
± hata payı (4): puanlar birbirine bu paydan daha yakın.
Kategori (2): kodlamada birinci olan, yaratıcı yazıda birinci olmayabilir.
Birkaç puanlık fark “daha iyi” demek değil; kendi işinizde deneyin.
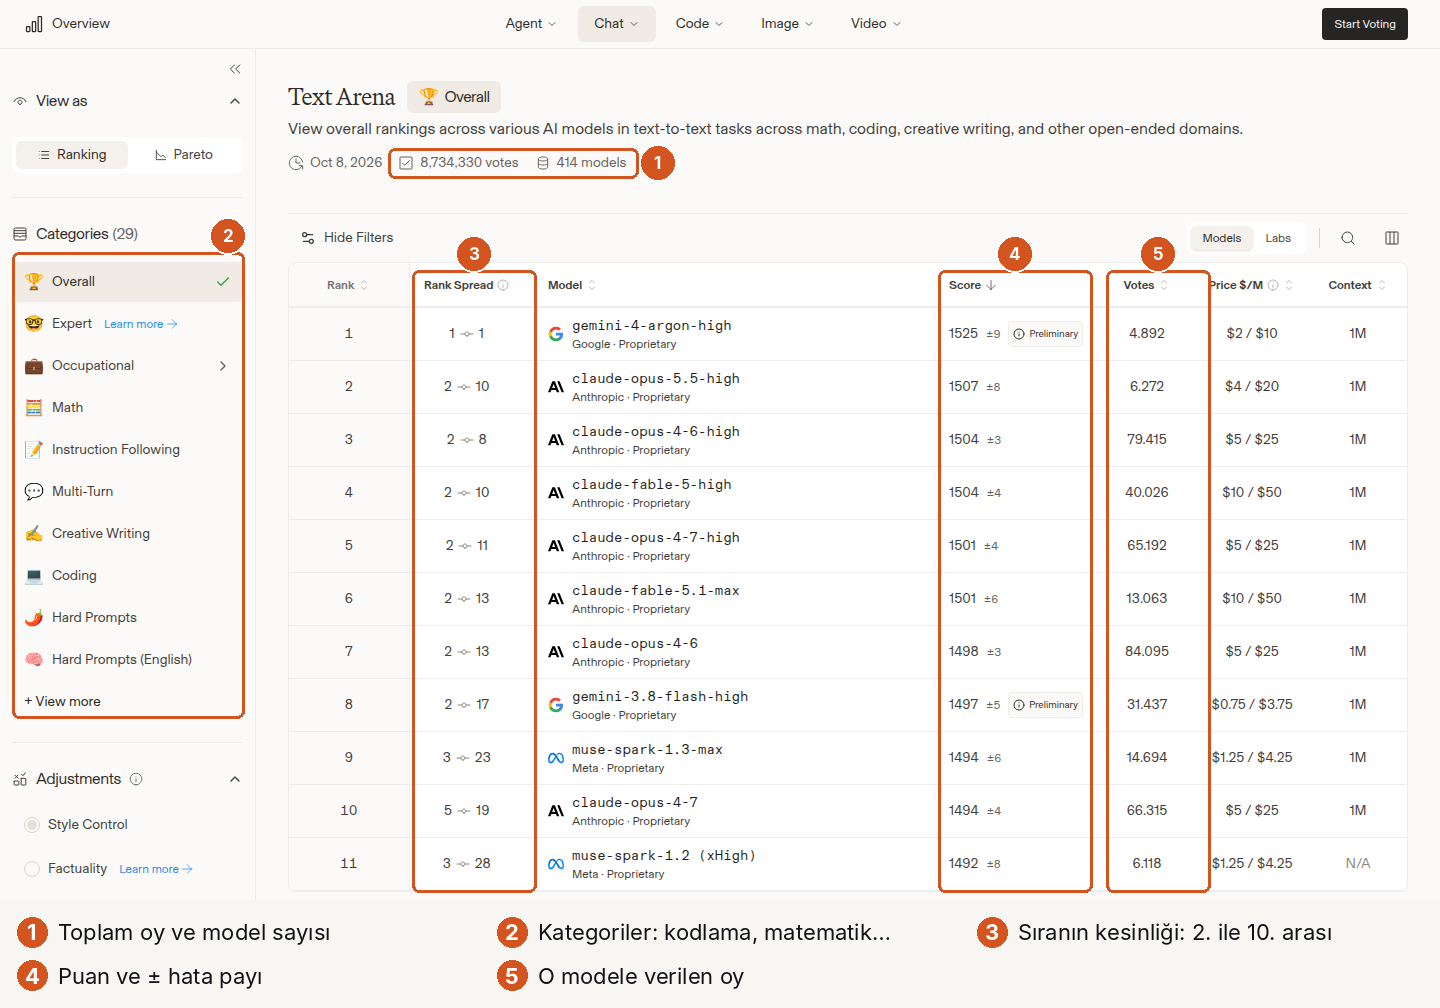
Ekran görüntüsü: lmarena.ai/leaderboard/text, 11 Ekim 2026.
02 · TARİHÇE
Dört yılda ne değişti?
| Kasım 2022 | Ekim 2026 | |
|---|---|---|
| Bağlam penceresi | ≈ 4 bin token | 1 milyon token standart |
| Girdi türü | Yalnızca metin | Metin, görüntü, ses, video, PDF |
| Güncel bilgi | Yok | Web araması yerleşik |
| Çalışma süresi | Tek cevap | Saatlerce süren ajan görevleri |
| Haftalık kullanıcı (ChatGPT) | 0 | ≈ 1,2 milyar |
Kaynak: OpenAI, Anthropic, Google model sayfaları; kullanıcı sayısı: TechnologyChecker derlemesi, Eylül 2026.
02 · TARİHÇE
Neden şimdi oldu?
Veri
İnternet: milyarlarca sayfa hazır metin.
Hesaplama
Oyun için üretilen GPU'lar, sinir ağı eğitimine çok uygun çıktı.
Mimari
Transformer bu ikisini verimli kullanabilen ilk tasarımdı.
Üçü de aynı on yıla denk geldi. Sinir ağı fikri 1950'lerden beri vardı; onu çalıştıracak veri ve donanım ancak şimdi hazır oldu.
Token
Modelin metni böldüğü parçalar. Kullanımın ölçüsü de ücreti de bunlarla hesaplanır.
03 · TOKEN
SORUBir LLM metni nasıl okur?
03 · TOKEN
Kelime ≠ token
Gerçek tokenizer çıktısı. Her renkli kutu bir token.
I love programming 3 kelime · 3 token
ChatGPT hallucinated a nonexistent citation. 5 kelime · 8 token
indistinguishable 1 kelime · 4 token
Sık geçen kısa kelimeler tek token. Uzun ya da nadir kelimeler İngilizcede de parçalanır; üstelik anlamlı yerlerinden değil.
OpenAI o200k_base tokenizer'ı (GPT-4o ve sonrası), tiktoken kütüphanesiyle hesaplandı.
03 · TOKEN
Aynı cümle, iki dil
I am going to school today. 6 kelime · 7 token
Bugün okula gidiyorum. 3 kelime · 7 token
Hello, how are you today? 5 kelime · 7 token
Merhaba, bugün nasılsın? 3 kelime · 9 token
Türkçe az kelimeyle çok şey söyler; ama her kelime daha çok parçaya bölünür.
Kendiniz deneyin: tiktokenizer.vercel.app · platform.openai.com/tokenizer · Hugging Face tokenizer playground (farklı modellerin tokenizer'ları)
03 · TOKEN
TAHMİN EDİNBu cümle kaç token?
Yapay zekâ, yazılım geliştirmeyi değiştiriyor.
Token sayısı videonun sağ üstünde. Tiktokenizer, o200k_base (GPT-4o ve sonrası): tiktokenizer.vercel.app · kayıt: 11 Ekim 2026
03 · TOKEN
Tokenizer'ı canlı görün
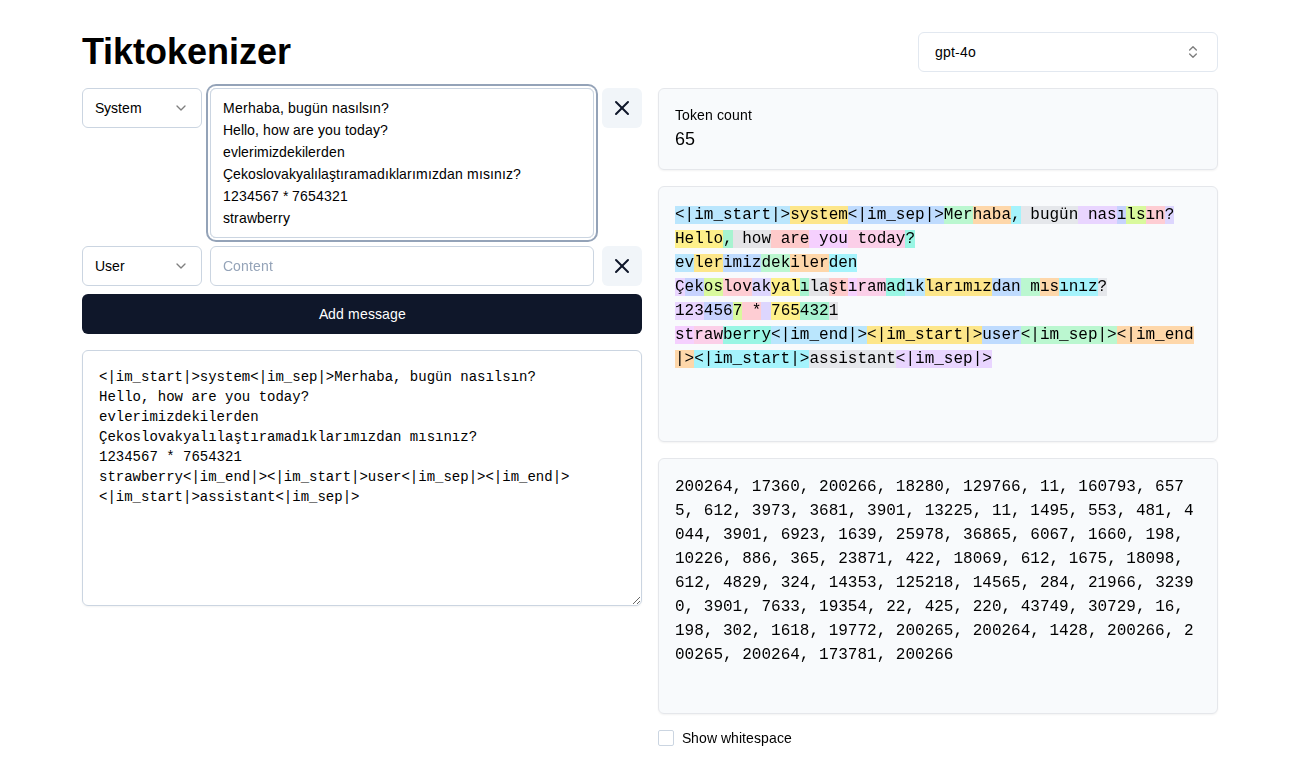
Ekran görüntüsü: tiktokenizer.vercel.app · sağ altta tokenların numaraları: model yalnızca bunları görür.
03 · TOKEN
Türkçe neden daha çok token harcar?
evlerimizdekilerden 6 token
from those in our houses 5 kelime, 5 token
Türkçe sondan eklemeli: tek kelimeye bir cümlelik anlam sığar. Tokenizer İngilizce ağırlıklı metinle eğitildiği için Türkçe ekleri tanımaz, kelimeyi parçalar.
03 · TOKEN
TAHMİNBu kelime kaç token?
Çekoslovakyalılaştıramadıklarımızdan mısınız?
Çekoslovakyalılaştıramadıklarımızdan mısınız?
19 token
03 · TOKEN
Türkçe yazmak kaç kat pahalı?
Aynı 2.009 cümle, İngilizcesine göre kaç kat token
“Türkçe 3 kat pahalı” söylentisi doğru değil; yaygın modellerde yaklaşık 1,4 kat.
Kaynak: M. T. Şahin, token-toll ölçümü.
03 · TOKEN
Pratik kural
≈ 4
karakter = 1 token
(İngilizce)
≈ 750
kelime = 1.000 token
(İngilizce)
≈ 500
kelime = 1.000 token
(Türkçe, kabaca)
1 milyon token ≈ 2.500 sayfa İngilizce metin. Kesin sayı için metni tokenizer'a yapıştırın.
03 · TOKEN
Neden harf ya da kelime değil?
Modelin bir sözlüğü (vocabulary) var: tanıdığı parçaların listesi. Yalnızca listedeki parçaları okuyup yazabilir. Listeye ne koymalı?
| Yöntem | “evlerimizdekilerden” | Sorun |
|---|---|---|
| Harf harf | 19 parça | Her metin çok uzar; model yavaşlar |
| Kelime kelime | 1 parça | ev, evler, evlerim, evlerimiz… hepsi listeye sığmaz; listede olmayan kelimeyi model okuyamaz |
| Token | evlerimizdekilerden 6 parça | Yok: model kelimeyi hiç görmemiş olsa da parçalarını tanır |
Güncel modellerin listesinde yaklaşık 100–200 bin parça var.
03 · TOKEN
KLASİK“strawberry” kelimesinde kaç tane r var?
03 · TOKEN
Model harfleri değil, numaraları görür
Harf saymak, tersten yazmak, kafiye bulmak: token sınırlarını aşan işler model için şaşırtıcı derecede zordur.
Güncel modeller bu soruyu çoğunlukla doğru cevaplıyor: ya “düşünerek” harfleri tek tek yazıyor ya da kod çalıştırıyor.
03 · TOKEN
TAHMİN EDİNHarfleri ayrı ayrı yazarsak ne olur?
strawberry 3 token. Aynı kelimeyi s t r a w b e r r y diye, harflerin arasına boşluk koyarak yazarsak kaç token olur? Bu, harf saymayı neden kolaylaştırır?
Tiktokenizer, o200k_base: tiktokenizer.vercel.app · kayıt: 11 Ekim 2026 · videodaki toplam 14 = 3 + satır sonu + 10
03 · TOKEN
3 dakikada: yapay zekâ neden “strawberry” yazamıyor?
TechCrunch, “AI can't spell strawberry. Here's why”
03 · TOKEN
Sayılar da parçalanır
1234567 * 7654321
Model 1234567 sayısını tek bir sayı olarak görmez; üç ayrı parça görür.
Büyük sayılarla çarpma neden zor? 4. bölümde bu resme geri döneceğiz.
03 · TOKEN
Token aynı zamanda para birimidir
1 milyon token başına API fiyatı (ABD doları)
| Model | Girdi | Çıktı |
|---|---|---|
| Claude Fable 5.1 · GPT-6 Astra | 10,00 | 50,00 |
| Claude Opus 5.5 | 4,00 | 20,00 |
| GPT-6.1 Sol · Claude Sonnet 5.5 | 2,00 | 10,00 |
| GPT-6 Luna | 0,10 | 0,50 |
Modelin yazdığı (çıktı) token, okuduğu (girdi) tokendan 5 kat pahalı. En ucuz ile en pahalı arasında 100 kat fark var.
03 · TOKEN
Token üç şeyi belirler
Maliyet
Fatura token başına kesilir. Türkçe yazınca fatura büyür.
Hız
Model tokenları tek tek üretir. Hız “saniyede token” ile ölçülür.
Kapasite
Modelin bir seferde görebildiği metin token ile sınırlıdır.
Üçüncüsünün adı bağlam penceresi. 3. bölümün konusu.
03 · TOKEN
SINIFTA DENEYİNKendi adınız kaç token?
- tiktokenizer.vercel.app ya da HF tokenizer playground adresini açın
- Adınızı ve soyadınızı yazın
- Aynı cümleyi Türkçe ve İngilizce yazıp token sayılarını karşılaştırın
- Bir emoji, bir sayı ve bir kod satırı deneyin
İçinde ç, ğ, ı, ö, ş, ü olan adlar genellikle daha çok tokena bölünür.
03 · TOKEN
Öğrenmek için sorun
Bu konuları yapay zekâyla birlikte öğrenmek için örnek istekler (14. sunum, “Yapay zekâyla öğrenmek”):
🗂️ Ben sınıflayayım
“Yapay zekâ, makine öğrenmesi, derin öğrenme ve LLM'i iç içe kutularla açıkla. Sonra 6 örnek ver; hangisinin hangi kutuya girdiğini ben söyleyeyim.”
🕰️ Ben sıralayayım
“2012, 2013, 2017 ve 2022'deki dönüm noktalarını karışık ver. Ben sıraya dizip her birinin neyi mümkün kıldığını yazayım.”
🔢 Önce tahminim
“Bana 5 cümle ver. Her birinin kaç token olacağını önce ben tahmin edeyim, sonra Tiktokenizer'da kontrol edelim.”
03 · TOKEN
1. bölümden akılda kalacaklar
- LLM bir tahmin makinesidir: sıradaki tokenı tahmin eder
- ChatGPT ürün, GPT model; ikisi aynı şey değil
- Bugünkü sıçramayı üç şey mümkün kıldı: Transformer (2017), internet verisi ve ekran kartları
- Model harf ya da kelime değil, token görür
- Token; maliyetin, hızın ve kapasitenin ölçü birimidir
Sırada: bu makine nasıl eğitiliyor ve içinde ne oluyor? → 2. bölüm
Bütün sunumlar · 2. sunum: Bir LLM nasıl üretilir, nasıl çalışır? →
Güvenç Usanmaz · github.com/gusanmaz