ÖYG213 · BÜYÜK DİL MODELLERİ · 2. BÖLÜM
Bir LLM nasıl üretilir, nasıl çalışır?
Önce bir modelin nasıl üretildiğine, sonra bir soruya nasıl cevap verdiğine bakıyoruz.
- Sıfırdan model üretmek
- Çıkarım (inference)
- Temperature
 Güvenç Usanmaz · github.com/gusanmaz
Geçen bölümden
- LLM sıradaki tokenı tahmin eder
- İçinde milyarlarca ayar düğmesi (parametre) vardır
- Metni harf ya da kelime değil, token olarak görür
Bugünün iki sorusu: Bu düğmeleri kim, nasıl ayarlıyor? Ayarlandıktan sonra bir soruya cevap nasıl çıkıyor?
Bir dil modeli sıfırdan nasıl üretilir?
Çok yukarıdan, kuş bakışı.
04 · MODEL ÜRETİMİ
TAHMİNGPT-4'ü eğitmenin yalnızca bilgisayar faturası ne kadardı?
04 · MODEL ÜRETİMİ
Eğitim faturası nasıl büyüdü?
Tek bir eğitim koşusunun tahmini hesaplama maliyeti (ABD doları)
Altı yılda yaklaşık 200.000 kat. Güncel modeller için milyar dolarlar konuşuluyor.
Kaynak: Stanford HAI, AI Index Report 2024, Epoch AI tahminleri.
04 · MODEL ÜRETİMİ
Üretim hattı: beş istasyon
Ardından: değerlendirme, güvenlik testleri, yayın. Paranın ve zamanın çoğu 3. istasyonda harcanır.
04 · MODEL ÜRETİMİ
1 · Veri: internetin büyük kısmını indir
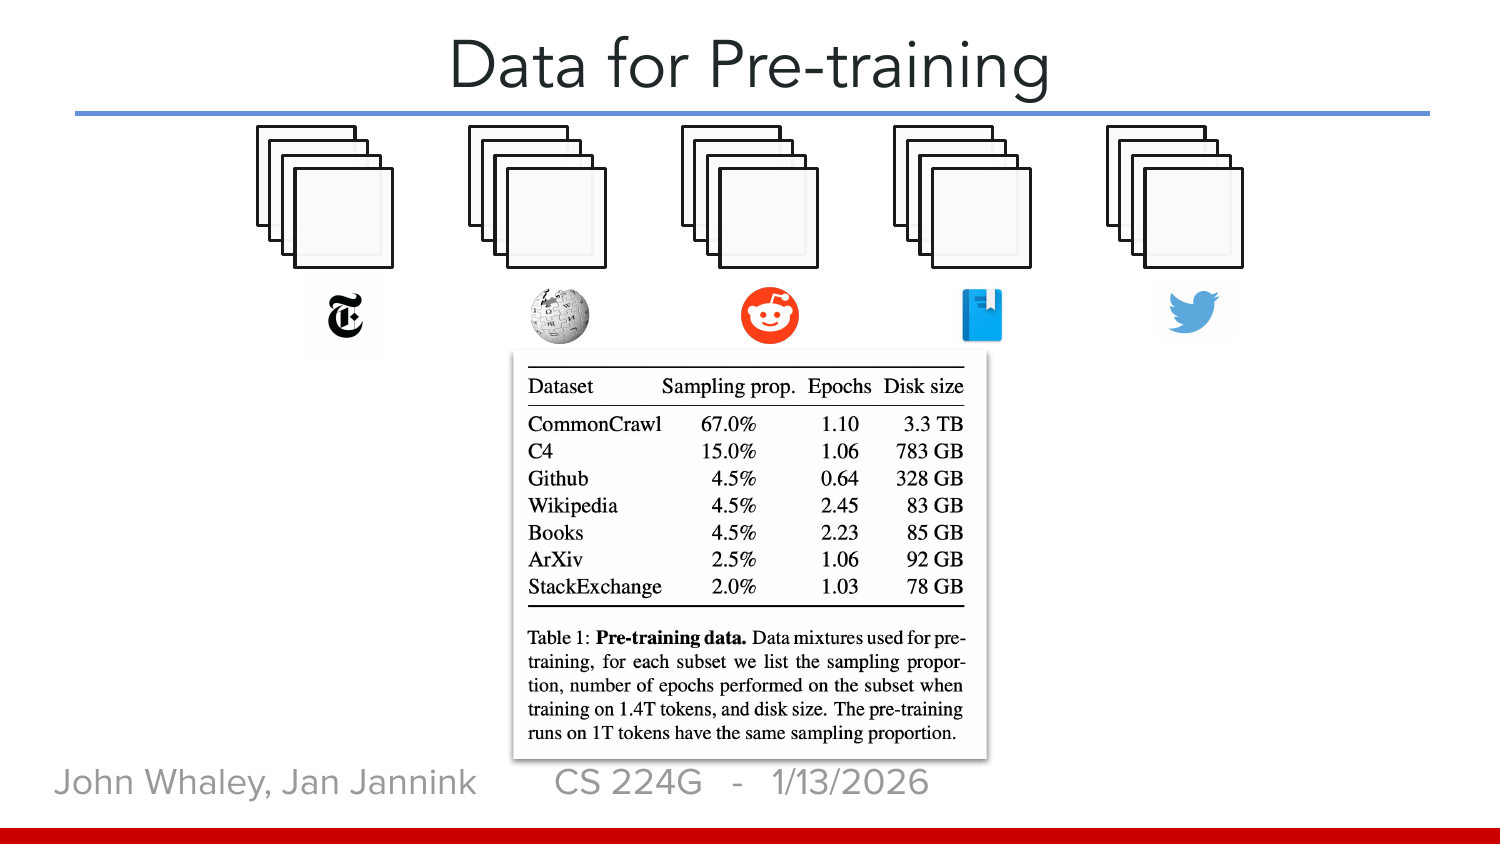
- Web sayfaları (Common Crawl)
- Wikipedia, kitaplar, makaleler
- GitHub'daki açık kodlar
- Forumlar: Reddit, Stack Overflow
Sonra temizlik: tekrarlar, spam, bozuk sayfalar ayıklanır.
04 · MODEL ÜRETİMİ
Ne kadar metin?
≈ 10 TB
Llama 2 (2023) için kullanılan metin
6.000
GPU, 12 gün boyunca kesintisiz
≈ 2 milyon $
O dönem “orta boy” sayılan bir model
Bir insan günde 8 saat okusa bu kadar metni bitirmesi on binlerce yıl sürerdi.
Kaynak: Andrej Karpathy, “Intro to Large Language Models” (2023).
04 · MODEL ÜRETİMİ
TARTIŞMABu metinleri yazanlara soruldu mu?
Şirketlerin savunması
“Model metni kopyalamıyor, ondan öğreniyor. İnsan da okuyarak öğrenir. Bu adil kullanımdır.”
Yazarların itirazı
“Emeğimiz izinsiz ve bedelsiz kullanıldı; üstelik bizimle rekabet eden bir ürün ortaya çıktı.”
Temmuz 2026'da Anthropic, yazarlarla 1,5 milyar dolarlık uzlaşmayı kesinleştirdi. Hukuk tarafına 6. bölümde döneceğiz.
04 · MODEL ÜRETİMİ
3 · Ön eğitim (pre-training): dünyanın en uzun boşluk doldurma sınavı
“Kedi paspasın üstüne ___”
Bunu trilyonlarca token için tekrarla.
04 · MODEL ÜRETİMİ
Kimse kural yazmıyor
Sıradaki tokenı iyi tahmin edebilmek için modelin şunları kendiliğinden öğrenmesi gerekir:
Dilbilgisi
“Kediler … ” ardından çoğul fiil gelir.
Olgular
“Türkiye'nin başkenti …” ardından Ankara gelir.
Akıl yürütme
“Katil, yani …” cümlesini tamamlamak için romanı anlamak gerekir.
Bu yüzden “yalnızca sıradaki kelimeyi tahmin ediyor” cümlesi doğrudur ama küçümseyicidir.
04 · MODEL ÜRETİMİ
Ön eğitimden çıkan şey: ham model (base model)
Ay'a inişi 6 yaşındaki bir çocuğa anlat.
Yerçekimi teorisini 6 yaşındaki bir çocuğa anlat.
Görelilik teorisini 6 yaşındaki bir çocuğa birkaç cümleyle anlat.
Büyük Patlama'yı 6 yaşındaki bir çocuğa anlat.
Cevap vermiyor; devam ettiriyor.
İnternette böyle bir cümlenin ardından çoğunlukla benzer sorular geliyor (bir ödev listesi gibi). Ham model soruyu “soru” olarak görmez.
Örnek: Ouyang ve ark., 2022 (InstructGPT) · Stanford CS224G 2026, 3. ders.
04 · MODEL ÜRETİMİ
4 · İnce ayar (fine-tuning): belge tamamlayıcıdan asistana
İnsanlar on binlerce örnek sohbet yazar:
- Soru → ideal cevap
- Zararlı istek → kibar ret
- Belirsiz soru → netleştirici soru
Model aynı yöntemle (sıradaki tokenı tahmin et) bu sefer bu sohbetler üzerinde kısa süre eğitilir.
Ay'a inişi 6 yaşındaki bir çocuğa anlat.
Çok büyük bir roket, içinde astronotlarla Dünya'dan havalandı ve Ay'a gitti. Astronotlar Ay'da yürüdüler, taş topladılar ve sağ salim eve döndüler.
04 · MODEL ÜRETİMİ
Ders kitabı benzetmesi
| Ders kitabında | Model eğitiminde | Ne kazandırır? |
|---|---|---|
| Konu anlatımı | Ön eğitim | Genel bilgi |
| Çözümlü örnekler | İnce ayar (insan yazımı örnekler) | Uzmanı taklit etme |
| Bölüm sonu alıştırmaları | Pekiştirmeli öğrenme (dene, puan al) | Kendi yolunu bulma |
Benzetme: Andrej Karpathy, “Deep Dive into LLMs like ChatGPT” (2025).
04 · MODEL ÜRETİMİ
5 · Hizalama (alignment): iyi cevabı ödüllendir
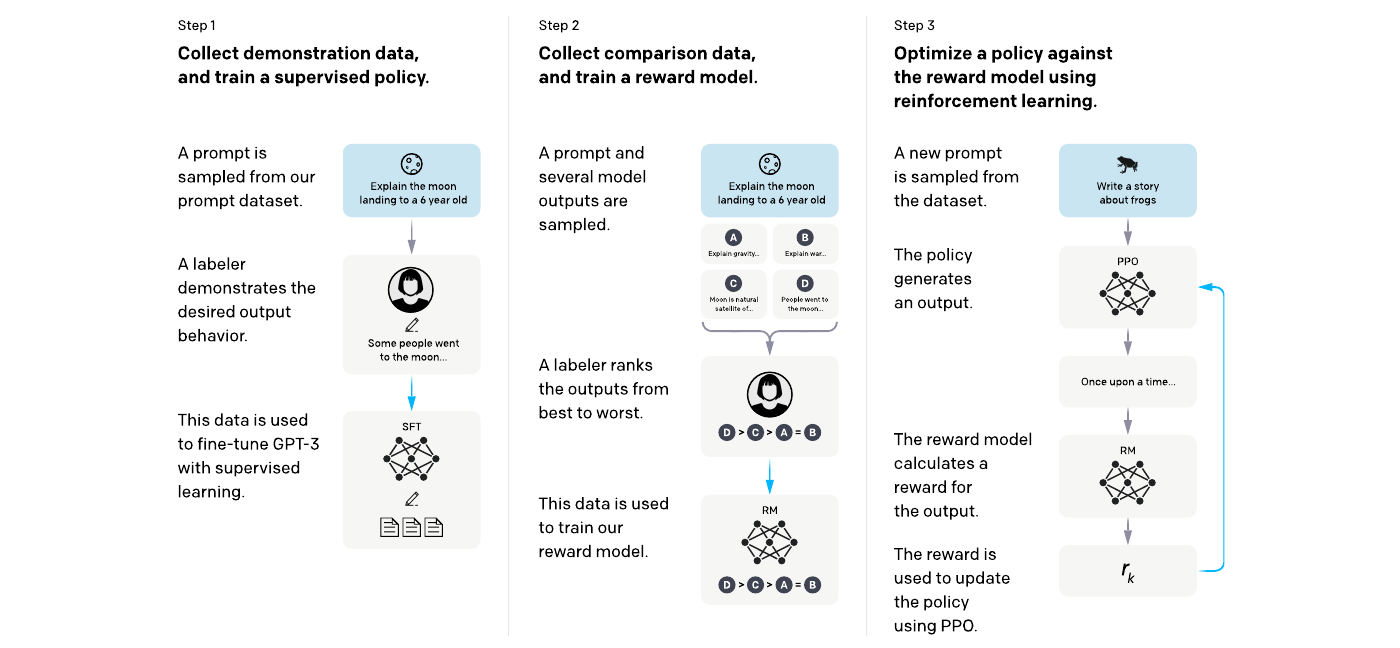
İnsanlar modelin iki cevabından iyisini seçer. Bu tercihlerden bir “hakem model” eğitilir; asıl model, hakemin beğendiği türden cevaplar verecek biçimde ayarlanır. Adı: RLHF.
Görsel: Ouyang ve ark., 2022, arxiv.org/abs/2203.02155, Şekil 2 · Ayrıntı 5. bölümde.
04 · MODEL ÜRETİMİ
Aşamaları yan yana koyalım
| Ön eğitim | İnce ayar | Hizalama | |
|---|---|---|---|
| Veri | İnternet: trilyonlarca token | On binlerce örnek sohbet | İnsan tercihleri |
| Süre | Aylar | Saatler–günler | Günler–haftalar |
| Maliyet | Milyonlar–milyarlar $ | Çok daha düşük | İnsan emeği pahalı |
| Sonuç | Belge tamamlayıcı | Asistan | Yardımsever, güvenli asistan |
04 · MODEL ÜRETİMİ
SORUModel, eğitimi bittikten sonra sizinle konuşurken öğrenmeye devam eder mi?
04 · MODEL ÜRETİMİ
Bunu kimler yapabiliyor?
Amiral gemisi model eğitmek için gerekenler:
- On binlerce üst düzey GPU
- Bir şehir kadar elektrik
- Milyarlarca dolar sermaye
- Dünyada sayılı uzman
Sonuç: merkezileşme
Bunu yapabilen şirket sayısı iki elin parmaklarını geçmiyor ve neredeyse tamamı ABD ile Çin'de. Herkesin indirebildiği açık modeller bu durumu bir ölçüde dengeliyor; 5. bölümde göreceğiz.
04 · MODEL ÜRETİMİ
Meraklısına: 100 dolara kendi ChatGPT'niz
Karpathy'nin nanochat projesi tüm hattı (token, ön eğitim, ince ayar, sohbet arayüzü) birkaç bin satırda gösteriyor.
- Kiralık 8 GPU'da yaklaşık 4 saat
- Sonuç: çocuk seviyesinde konuşan küçük bir model
Video: Karpathy, “Let's build GPT: from scratch, in code, spelled out” — ileri seviye, Python bilgisi gerektirir.
LLM nasıl çalışır?
Enter'a bastığınız andan cevabın son harfine kadar.
05 · ÇIKARIM (İNFERENCE)
SORUChatGPT'de cevap neden kelime kelime akıyor?
05 · ÇIKARIM (İNFERENCE)
Tek bir döngü
↻ Bitiş tokenı gelene kadar tekrarla
Buna özbağlanımlı (autoregressive) üretim denir.
05 · ÇIKARIM (İNFERENCE)
Döngü, hareketli
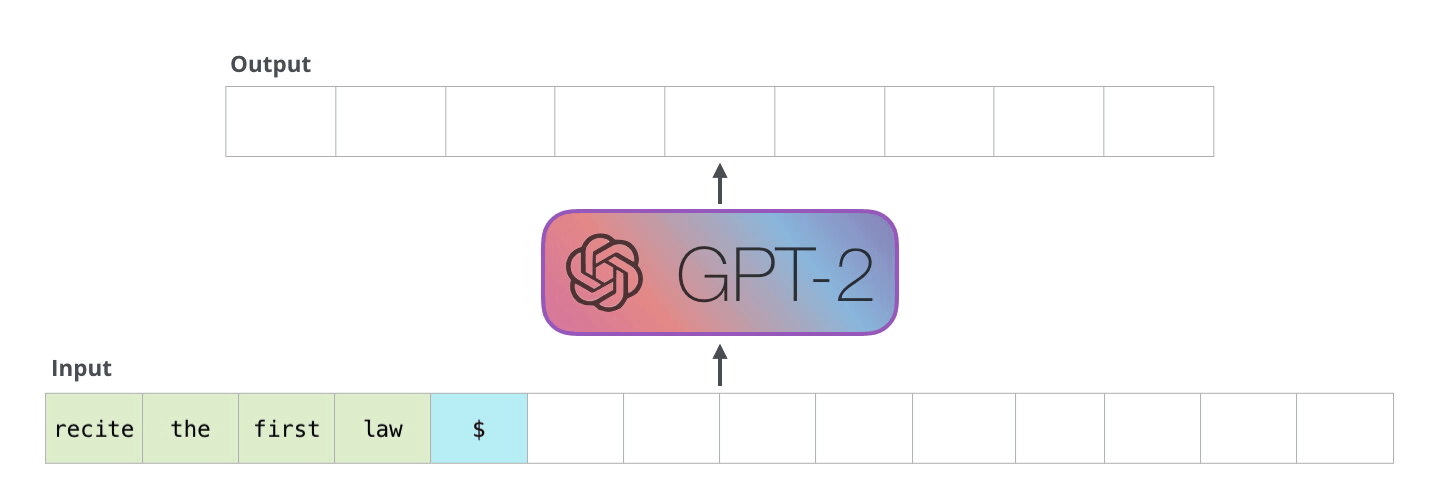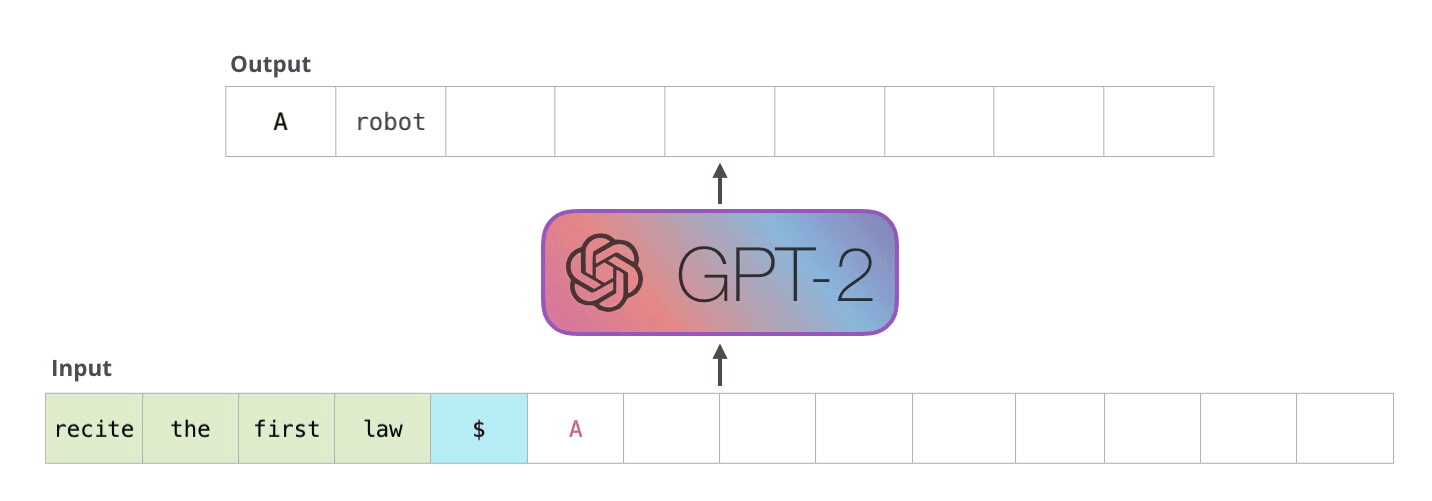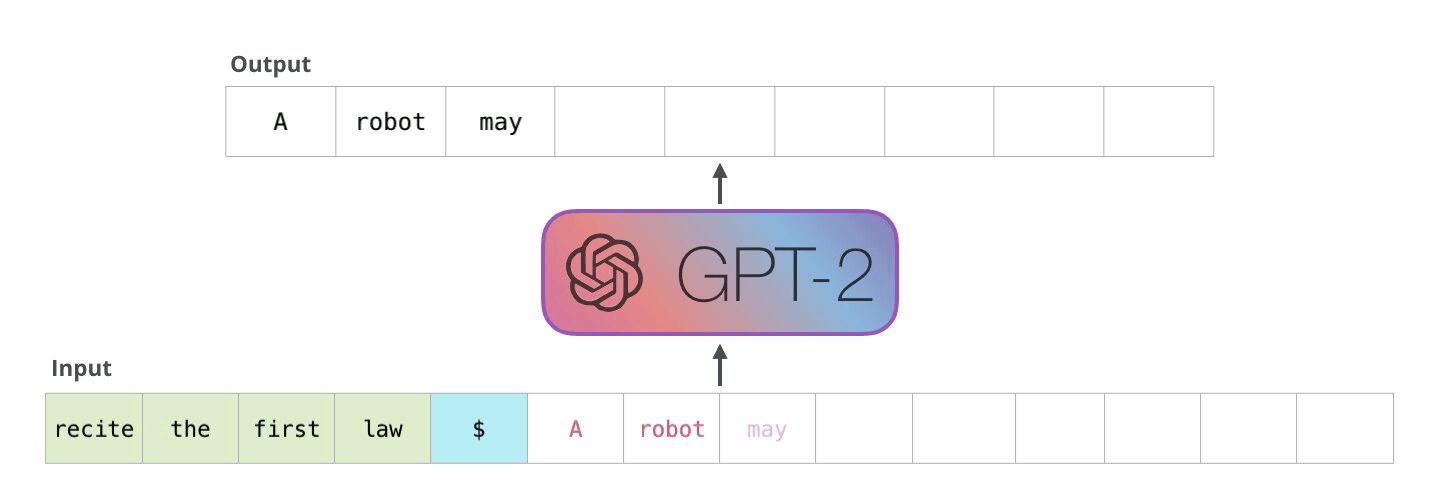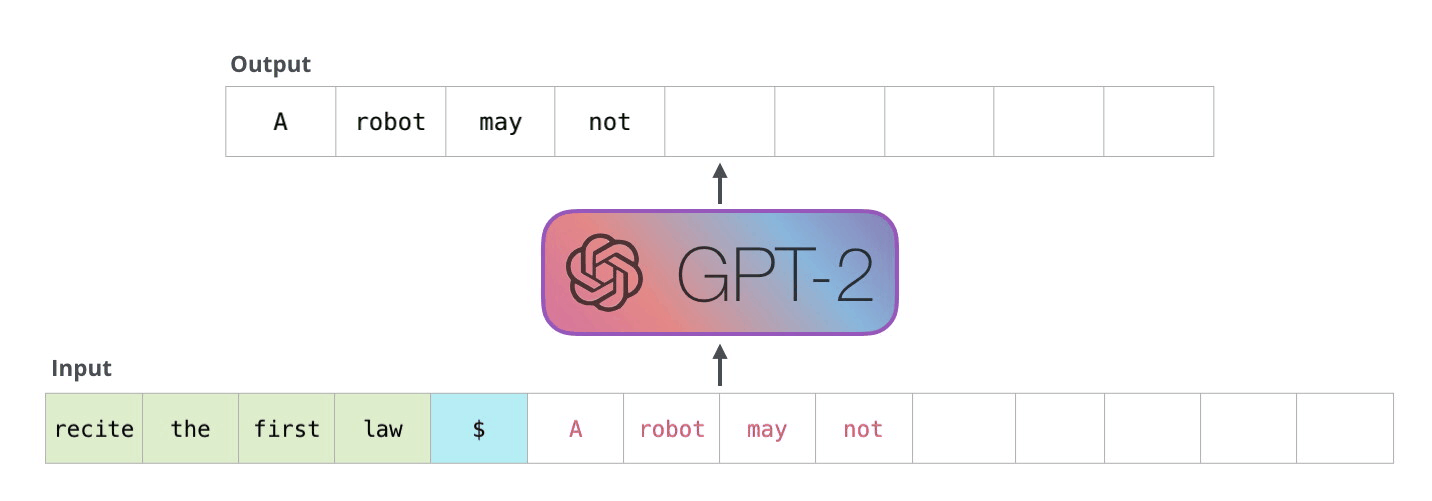
Üretilen her token girdinin sonuna eklenir; hepsi yeniden modele verilir.
Animasyon: Jay Alammar, The Illustrated GPT-2
05 · ÇIKARIM (İNFERENCE)
Adım adım izleyelim
Türkiye'nin başkenti
05 · ÇIKARIM (İNFERENCE)
Adım adım izleyelim
Türkiye'nin başkenti Ankara
05 · ÇIKARIM (İNFERENCE)
Adım adım izleyelim
Türkiye'nin başkenti Ankara'dır
Her adımda model bütün metni baştan okur. Olasılıklar temsilidir.
05 · ÇIKARIM (İNFERENCE)
Kutunun içi: üç aşama
Detayları bilmek zorunda değilsiniz. Bilmeniz gereken: içeride bir veritabanı sorgusu yok, yalnızca çok sayıda çarpma ve toplama var.
05 · ÇIKARIM (İNFERENCE)
SİZ ÇÖZÜN“yüz” kelimesi ne demek?
Cebimde yüz lira var.
sayı
Sabah yüzünü yıka.
surat
Denizde biraz yüz.
fiil
Anlamı kelimenin kendisinden değil, komşularından çıkardınız. Modelin de aynısını yapması gerekir.
05 · ÇIKARIM (İNFERENCE)
Dikkat (attention): her token komşularına bakar
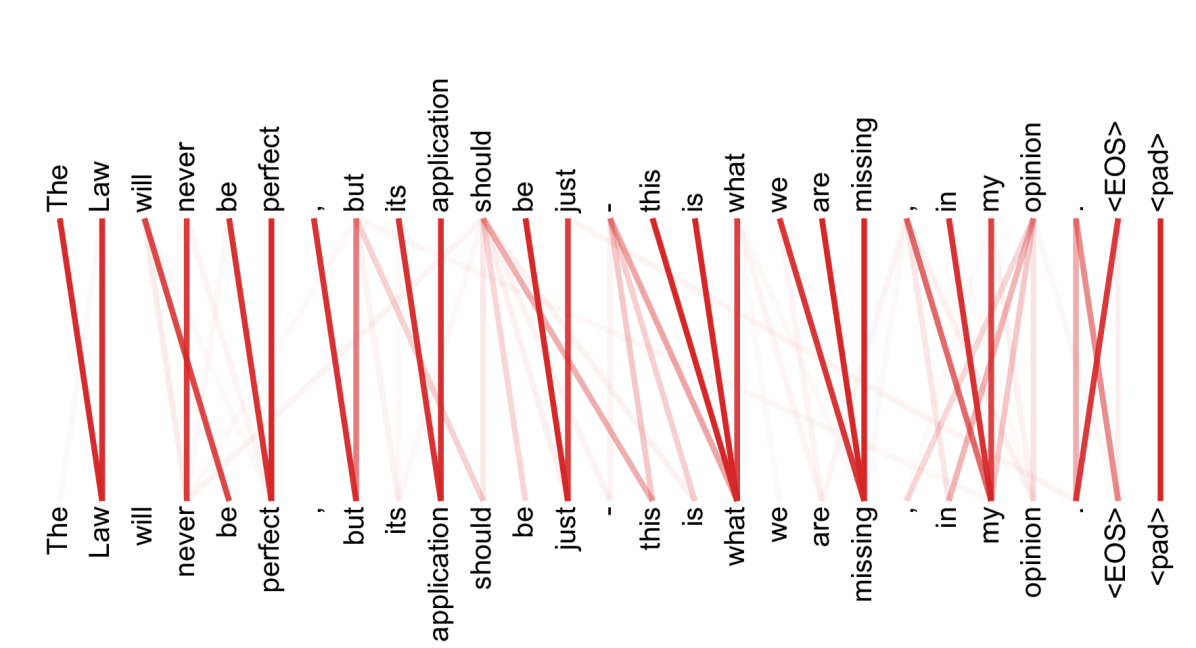
- Her token diğer tokenlara “bana ne kadar lazımsın?” diye sorar
- Önemli olanlardan bilgi alır
- “yüz” tokenı “lira”yı görünce sayı anlamına kayar
Transformer'ın 2017'deki yeniliği buydu.
05 · ÇIKARIM (İNFERENCE)
SİZ ÇÖZÜN“it” (o) kimi kastediyor?
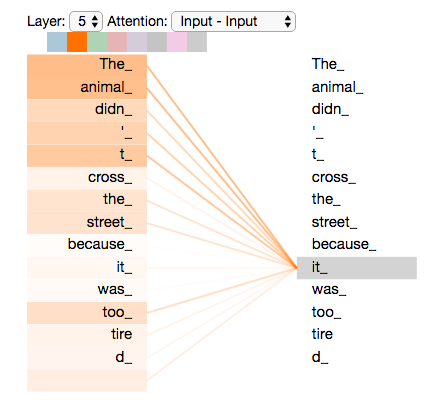
The animal didn't cross the street because it was too tired.
Hayvan caddeyi geçmedi çünkü o çok yorgundu.
Çizgilerin koyuluğu dikkatin nereye gittiğini gösteriyor: model “it” için en çok The animal'a bakıyor.
Görsel: Jay Alammar, The Illustrated Transformer
05 · ÇIKARIM (İNFERENCE)
Kendiniz kurcalayın: Transformer Explainer
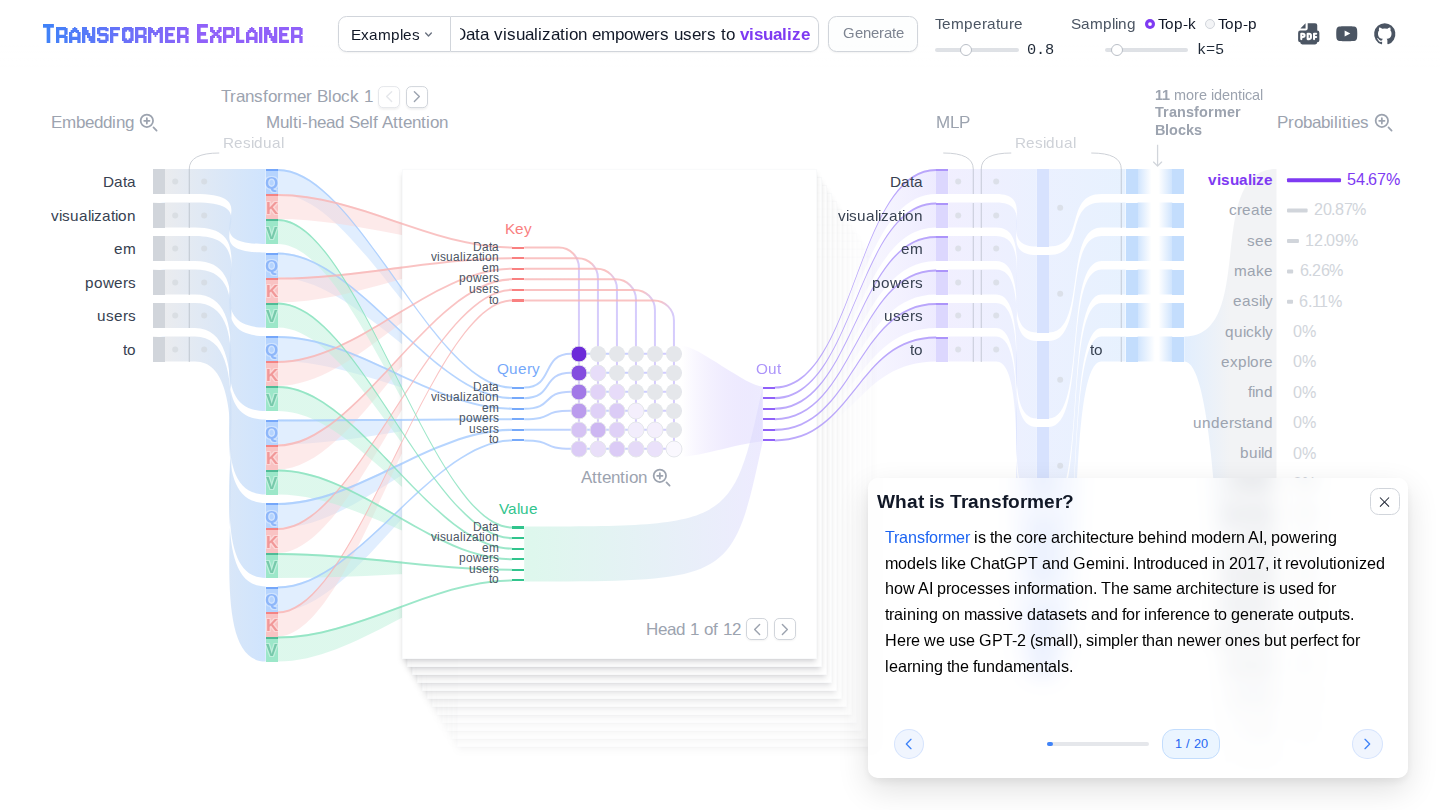
Tarayıcıda çalışan gerçek bir GPT-2: poloclub.github.io/transformer-explainer · Georgia Tech Polo Club
05 · ÇIKARIM (İNFERENCE)
Üç boyutlu tur: LLM Visualization
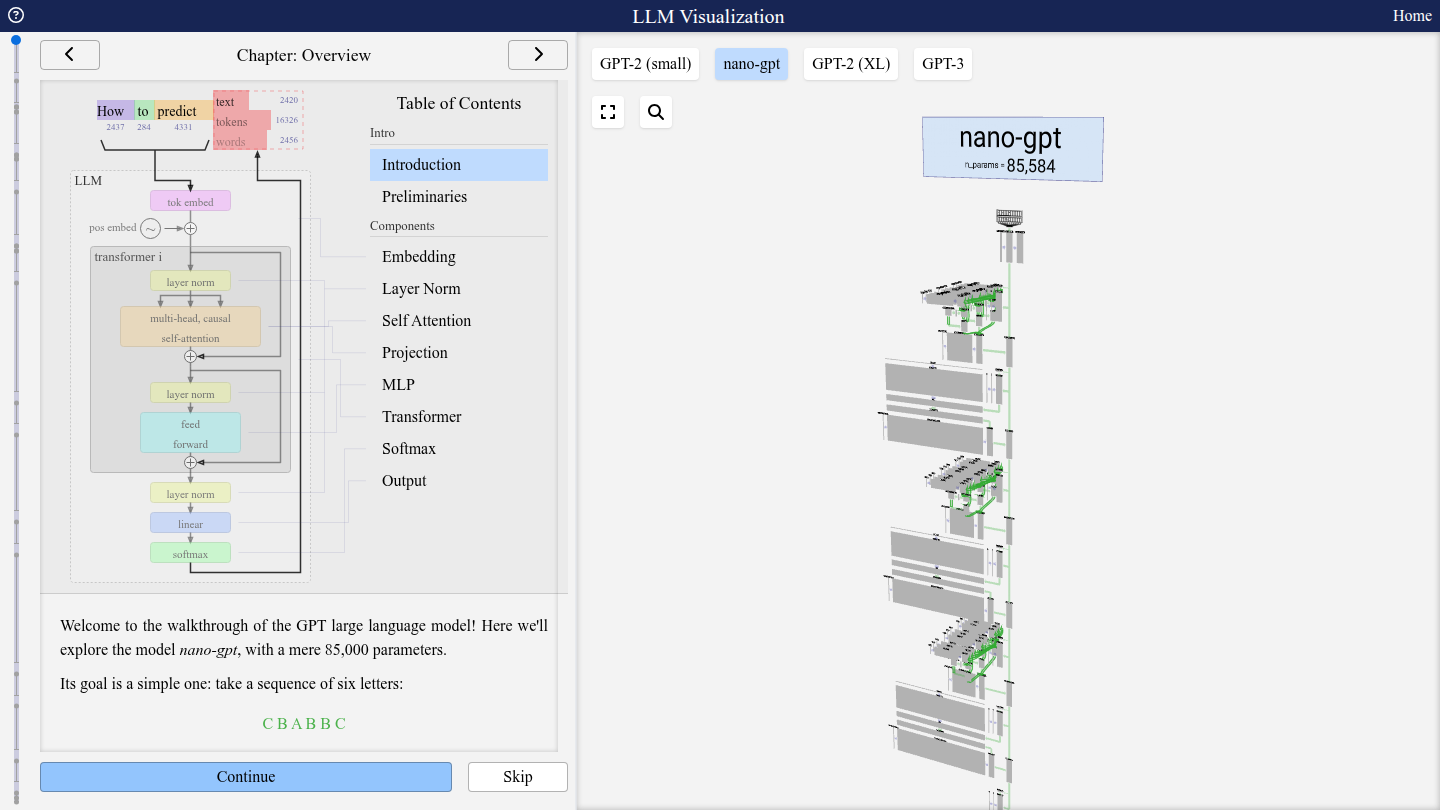
Her çarpma işlemini adım adım gösterir: bbycroft.net/llm · Brendan Bycroft
05 · ÇIKARIM (İNFERENCE)
TAHMİN EDİNGPT-3, bu minik modelden kaç kat büyük?
Videodaki nano-gpt 85.584 parametrelik bir GPT; tek işi altı harfi alfabe sırasına dizmek.
LLM Visualization, bbycroft.net/llm · Brendan Bycroft · kayıt: 11 Ekim 2026
05 · ÇIKARIM (İNFERENCE)
Her token için aynı miktarda emek
Model zor bir soruda durup düşünemez. Her token için ağdan bir kez geçilir ve sonuç yazılır.
Bu, bizim 2 + 2'ye düşünmeden cevap vermemize benzer.
Peki zor sorular?
Modele “önce karalama yap” dersek, karaladığı tokenlar sonraki tokenlar için girdi olur. Düşünen modeller tam olarak bunu yapar; 4. bölümde göreceğiz.
05 · ÇIKARIM (İNFERENCE)
Model hiçbir şey hatırlamaz: durumsuz (stateless)
Adım Elif.
Memnun oldum Elif!
Adım neydi?
Elif.
Her mesajınızda uygulama tüm sohbeti baştan gönderir. Model her seferinde sıfırdan okur.
05 · ÇIKARIM (İNFERENCE)
TAHMİN EDİNAdımızı söyledik; yeni bir komutta hatırlar mı?
gemma3:4b, Ollama 0.13.5, yerel bilgisayar · terminal kaydı: Ekim 2026
05 · ÇIKARIM (İNFERENCE)
Sizin görmediğiniz metin: sistem promptu (system prompt)
Model bugünün tarihini “bilmez”; ona söylenir. Aynı model, farklı sistem promptuyla bambaşka bir karaktere bürünür.
Anthropic, Claude'un sistem promptlarını yayımlıyor: platform.claude.com/docs/en/release-notes/system-prompts
05 · ÇIKARIM (İNFERENCE)
Eğitim (training) ve çıkarım (inference)
| Eğitim (training) | Çıkarım (inference) | |
|---|---|---|
| Ne olur? | Parametreler değişir | Parametreler sabittir, cevap üretilir |
| Ne zaman? | Model yayımlanmadan önce, bir kez | Her mesajınızda |
| Süre | Aylar | Saniyeler |
| Kim öder? | Modeli üreten şirket | Kullanan herkes (token başına) |
Donanım ve maliyet konuşurken bu ayrım çok işe yarayacak.
05 · ÇIKARIM (İNFERENCE)
Perde arkası, Karpathy'nin anlatımıyla
Andrej Karpathy, “How I use LLMs” (2025), 02:54 – “ChatGPT interaction under the hood” · youtube.com/watch?v=EWvNQjAaOHw
Temperature
Aynı soruya neden her seferinde farklı cevap gelir?
06 · TEMPERATURE
SORUAynı soruyu, aynı modele iki kez sorarsanız…
06 · TEMPERATURE
GERÇEK DENEMEAynı soru, aynı model, üç cevap
gemma3:4b, Ollama 0.13.5, yerel bilgisayar · terminal kaydı: Ekim 2026
06 · TEMPERATURE
Örnekleme (sampling): en olası token şart değil
“Bugün hava çok ___”
100 kez sorarsanız yaklaşık 34'ünde “güzel”, 21'inde “sıcak” gelir. Buna örnekleme (sampling) denir.
06 · TEMPERATURE
Temperature: çekilişin ne kadar cesur olacağı
Düşük · 0,2
Hep aynı, güvenli, sıkıcı
Orta · 1,0
Modelin öğrendiği dağılım
Yüksek · 1,8
Şaşırtıcı, bazen saçma
Değerler temsilidir. Düşük temperature en olası tokenı öne çıkarır; yüksek temperature olasılıkları birbirine yaklaştırır.
06 · TEMPERATURE
TAHMİN EDİNTemperature 0,8'den 0,2'ye inince ne olur?
GPT-2'ye “Data visualization empowers users to …” veriliyor. Temperature 0,8'de visualize %54,67 olasılıkla önde.
Transformer Explainer (GPT-2, tarayıcıda), poloclub.github.io/transformer-explainer · kayıt: 11 Ekim 2026 · sitede yalnızca en olası 5 kelime çekilişe girer (top-k = 5)
06 · TEMPERATURE
Hangi işte hangi ayar?
| İş | Temperature | Neden? |
|---|---|---|
| Kod yazma, veri çıkarma, sınıflandırma | Düşük (0 – 0,3) | Tutarlılık ve doğruluk gerekir |
| Genel sohbet, açıklama | Orta (0,7 – 1) | Doğal ama dağılmayan dil |
| İsim bulma, beyin fırtınası, şiir | Yüksek (1 – 1,5) | Çeşitlilik istenir |
Sohbet uygulamalarında bu ayarı göremezsiniz; şirket sizin yerinize seçer. API'de ve yerel modellerde siz belirlersiniz.
06 · TEMPERATURE
Akrabaları: top-k ve top-p
top-k
Yalnızca en olası k token arasından seç. k = 1 ise her zaman birinciyi alır.
top-p
En olasıdan başlayıp olasılıkları toplamı p'ye ulaşana kadarki tokenlar arasından seç. p = 0,9 yaygın bir değerdir.
Üçü de aynı soruya cevap verir: “Seçim yaparken ne kadar risk alalım?”
06 · TEMPERATURE
TUZAK SORUTemperature 0 yaparsam her seferinde aynı cevabı alır mıyım?
06 · TEMPERATURE
Yazılımcı için sonuçları
Alışık olduğumuz dünya
Aynı girdi → aynı çıktı.
Bir test yazarsınız; geçerse iş biter.
LLM'li dünya
Aynı girdi → benzer ama farklı çıktılar.
Bugün çalışan prompt yarın farklı davranabilir.
- Beğenmediğiniz cevabı yeniden ürettirin; ikincisi daha iyi olabilir
- Kritik işte tek cevaba güvenmeyin; birkaç kez deneyip karşılaştırın
- LLM çıktısını her zaman kontrol eden bir adım koyun
06 · TEMPERATURE
SINIFTA DENEYİNKaydırıcıyla oynayın
- Transformer Explainer'ı açın
- Temperature'ı en sola (0,2) getirip birkaç kez Generate'e basın
- 2 yapıp tekrar deneyin
- Sağdaki olasılık çubuklarının nasıl değiştiğine bakın
Sonra kendi sohbet uygulamanızda aynı soruyu üç ayrı pencerede sorun: “Bir kedi için 5 isim öner.”
06 · TEMPERATURE
Öğrenmek için sorun
Bu konuları yapay zekâyla birlikte öğrenmek için örnek istekler (14. sunum, “Yapay zekâyla öğrenmek”):
🧩 Ben sıralayayım
“Veri, tokenlara bölme, ön eğitim, ince ayar ve hizalama aşamalarını karışık ver. Ben sıraya dizip her aşamanın ne ürettiğini yazayım.”
🔁 Döngüyü oynayalım
“‘Bugün hava çok’ cümlesini beş tur devam ettirelim. Her turda sıradaki tokenı önce ben tahmin edeyim, sonra seçeneklerini göster.”
🌡️ Ayarı ben seçeyim
“6 iş say: kod, JSON'dan veri çıkarma, şiir, beyin fırtınası… Her biri için temperature'ı ben seçeyim, sen gerekçemi değerlendir.”
06 · TEMPERATURE
2. bölümden akılda kalacaklar
- Üretim hattı: veri → token → ön eğitim → ince ayar → hizalama
- Ön eğitim pahalıdır ve yalnızca metni devam ettiren bir model üretir; onu asistana çeviren ince ayardır
- Çıkarım bir döngüdür: oku, hesapla, seç, ekle
- Model durumsuzdur: her mesajda tüm sohbet yeniden gönderilir
- Cevap çekilişle seçilir; temperature bu çekilişin ayarıdır
Sırada: her mesajda bütün sohbetin yeniden gönderilmesi bize neye mal oluyor? → 3. bölüm
← 1. sunum: LLM nedir, nereden geldi? · Bütün sunumlar · 3. sunum: Bağlam, bellek ve halüsinasyon →
Güvenç Usanmaz · github.com/gusanmaz